Comment ils fonctionnent ensemble
Les trois éléments forment un pipeline court et à sens unique, avec le jeu de données au centre :
- Une tâche de capture de données écrit le contenu capturé du site web dans un jeu de données mémoire.
- Le jeu de données le stocke et l’indexe, ce qui le rend interrogeable.
- Un assistant lit depuis le jeu de données pour répondre aux questions.
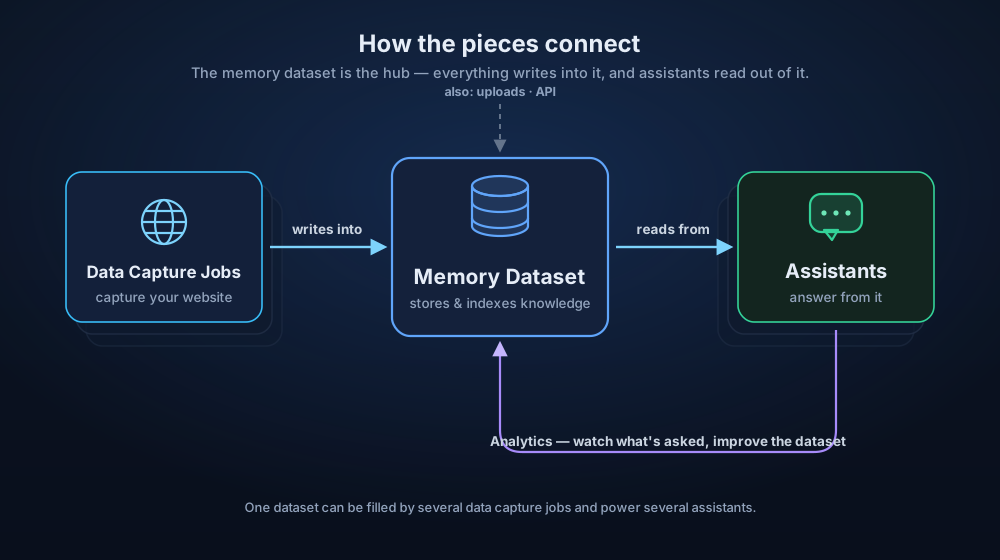
Le jeu de données est le hub, et les relations se déploient de chaque côté : un jeu de données peut être rempli par plusieurs tâches de capture de données (ainsi que par des imports et l’API), et ce même jeu de données peut alimenter plusieurs assistants. Modifiez les connaissances une seule fois, dans le jeu de données, et chaque assistant qui y est connecté s’améliore au même instant.
Comme la tâche de capture de données et l’assistant ne communiquent jamais qu’à travers le jeu de données, ils restent indépendants — vous pouvez relancer une capture pour rafraîchir le contenu sans toucher à l’assistant, et réajuster l’assistant sans recapturer.
La boucle, de bout en bout
Le pipeline devient réellement une boucle dès qu’un assistant est en ligne et que vous commencez à l’écouter :
- Une tâche de capture de données remplit le jeu de données à partir de votre centre d’aide.
- L’assistant répond aux visiteurs en s’appuyant sur ce contenu.
- Les analyses révèlent une question récurrente à laquelle il répond mal.
- Vous ajoutez le contenu manquant au jeu de données (ou recapturez la page qui a changé).
- Le visiteur suivant obtient une réponse solide.
Cette boucle de rétroaction — observer ce qui est demandé, combler le manque dans le jeu de données — est la façon dont un bon assistant s’améliore au fil du temps, sans jamais avoir à le reconstruire.
Pour aller plus loin
- Analyses
- Consulter les analyses d’un assistant
- Planifier une tâche de capture de données
- Analysez le contenu extrait