Come funzionano insieme
I tre elementi formano una pipeline breve e a senso unico, con il dataset al centro:
- Un job di acquisizione dati scrive i contenuti acquisiti dal sito web in un dataset di memoria.
- Il dataset li salva e li indicizza, rendendoli ricercabili.
- Un assistente legge dal dataset per rispondere alle domande.
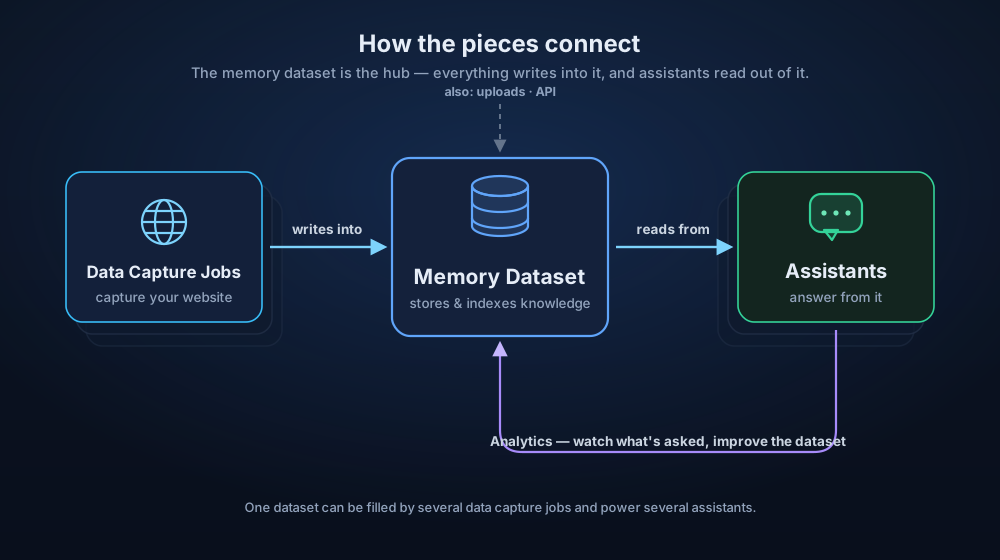
Il dataset è l’hub e le relazioni si diramano da entrambi i lati: un dataset può essere riempito da più job di acquisizione dati (e da caricamenti e dall’API) e lo stesso dataset può alimentare più assistenti. Cambia la conoscenza una volta, nel dataset, e ogni assistente collegato migliora nello stesso momento.
Poiché il job di acquisizione dati e l’assistente comunicano sempre e solo attraverso il dataset, restano indipendenti: puoi rieseguire un’acquisizione per aggiornare i contenuti senza toccare l’assistente, e rifinire l’assistente senza riacquisire nulla.
Il ciclo, dall’inizio alla fine
La pipeline diventa davvero un ciclo quando un assistente è online e inizi ad ascoltarlo:
- Un job di acquisizione dati riempie il dataset dal tuo centro assistenza.
- L’assistente risponde ai visitatori, basandosi su quei contenuti.
- Le analisi mostrano una domanda che le persone continuano a fare e a cui risponde male.
- Aggiungi al dataset i contenuti mancanti (o riacquisisci la pagina che è cambiata).
- Il visitatore successivo riceve una risposta solida.
Questo ciclo di feedback (osservare cosa viene chiesto, colmare la lacuna nel dataset) è il modo in cui un buon assistente migliora nel tempo, senza mai doverlo ricostruire.
Approfondisci
- Analisi
- Leggi le analisi dell’assistente
- Pianifica un job di acquisizione dati
- Analizza i contenuti estratti