So arbeiten sie zusammen
Die drei Bausteine bilden eine kurze Pipeline in eine Richtung, mit dem Datensatz im Zentrum:
- Ein Datenerfassungsjob schreibt erfasste Website-Inhalte in einen Memory-Datensatz.
- Der Datensatz speichert und indexiert sie und macht sie durchsuchbar.
- Ein Assistent liest aus dem Datensatz, um Fragen zu beantworten.
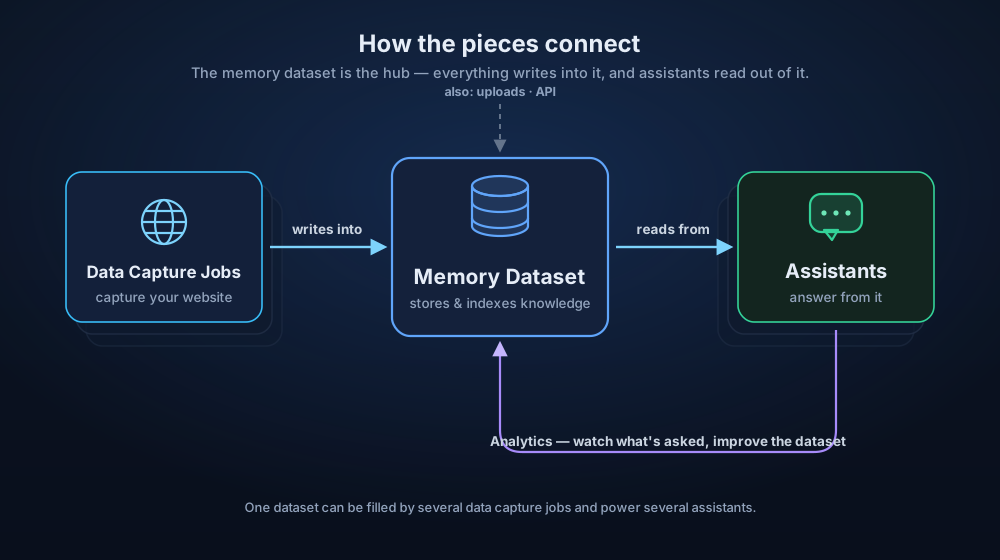
Der Datensatz ist der Knotenpunkt, und die Beziehungen fächern sich zu beiden Seiten auf: Ein Datensatz kann von mehreren Datenerfassungsjobs befüllt werden (sowie durch Uploads und die API), und derselbe Datensatz kann mehrere Assistenten antreiben. Ändern Sie das Wissen einmal im Datensatz, und jeder damit verbundene Assistent wird im selben Moment besser.
Da Datenerfassungsjob und Assistent ausschließlich über den Datensatz kommunizieren, bleiben sie unabhängig – Sie können eine Erfassung erneut ausführen, um Inhalte zu aktualisieren, ohne den Assistenten anzufassen, und den Assistenten neu abstimmen, ohne neu zu erfassen.
Der Kreislauf von Anfang bis Ende
Die Pipeline wird erst dann wirklich zu einem Kreislauf, wenn ein Assistent live ist und Sie ihm zuhören:
- Ein Datenerfassungsjob befüllt den Datensatz aus Ihrem Hilfecenter.
- Der Assistent beantwortet Besucherfragen auf Grundlage dieser Inhalte.
- Die Analysen zeigen eine Frage, die immer wieder gestellt und schlecht beantwortet wird.
- Sie ergänzen die fehlenden Inhalte im Datensatz (oder erfassen die geänderte Seite neu).
- Schon der nächste Besucher bekommt eine solide Antwort.
Dieser Feedback-Kreislauf – beobachten, was gefragt wird, und die Lücke im Datensatz schließen – ist der Weg, wie ein guter Assistent mit der Zeit besser wird, ohne ihn jemals neu aufzubauen.
Mehr erfahren
- Analysen
- Assistenten-Analysen lesen
- Einen Datenerfassungsjob planen
- Ihre extrahierten Inhalte analysieren