Datenerfassungsjobs
Ein Datenerfassungsjob ist der wichtigste Weg, einen Datensatz aus einer Website zu befüllen. Sie richten ihn auf eine oder mehrere Seiten aus, und er sammelt deren Inhalte in einem Memory-Datensatz – ohne Kopieren und Einfügen, ohne manuelle Eingabe, und er kann sich nach Zeitplan wiederholen, damit Ihr Wissen nie veraltet.
So funktioniert ein Datenerfassungsjob
Er arbeitet sich Seite für Seite nach außen vor. Er öffnet eine Startseite, extrahiert und speichert deren Inhalt, liest die Links auf dieser Seite und folgt dann diesen gefundenen Links zu den nächsten Seiten – so lange, bis er die von Ihnen gesetzten Grenzen erreicht. Diese Grenzen sind die ganze Kunst einer guten Erfassung:
- Wohin er geht – die Start-URLs, die erlaubten Hostnamen und ein- bzw. ausgeschlossene Pfade.
- Wie weit – die Linktiefe (wie viele Sprünge vom Start entfernt) und der Erfassungsumfang, eine Seitenobergrenze von Preview (100) bis Large (5000).
- Wie aktuell – ein optionaler Zeitplan sowie eine Lebensdauer für Inhalte, die Seiten automatisch neu verarbeitet, wenn sie altern.
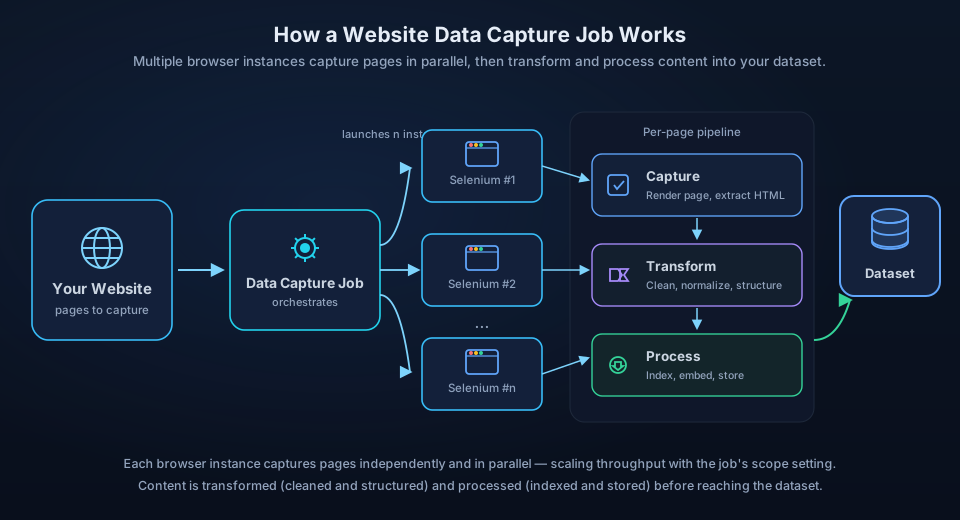
Um zum Beispiel ein Produkthandbuch in Wissen zu verwandeln, ohne die Marketing-Website mitzunehmen, starten Sie bei
https://acme.com/docs/, beschränken den Hostnamen aufacme.com, schließen nur*/docs/*ein, setzen eine Tiefe von 3, wählen den Umfang Medium und planen eine wöchentliche Neuerfassung. Das Ergebnis: Das Handbuch bleibt von selbst aktuell, und Login- und Checkout-Seiten werden nie erfasst.
Erfassen ist nicht der einzige Weg, einen Datensatz zu befüllen
Ein Datenerfassungsjob erfasst Websites, Sie können aber auch Dateien hochladen oder Inhalte über die Content-API (eine Enterprise-Funktion) einspielen. Alle drei landen im selben Datensatz und werden gemeinsam durchsucht – ein Datensatz besteht also selten nur aus einer Quelle.