Trabajos de captura de datos
Un trabajo de captura de datos es la forma principal de llenar un dataset a partir de una web. Lo apuntas a una o varias páginas y recopila su contenido en un dataset de memoria: sin copiar y pegar, sin introducir datos a mano, y puede repetirse de forma programada para que tu conocimiento nunca se quede desactualizado.
Cómo funciona un trabajo de captura de datos
Avanza hacia fuera, página a página. Abre una página de inicio, extrae y guarda su contenido, lee los enlaces de esa página y luego sigue esos enlaces descubiertos hasta las páginas siguientes, repitiendo el proceso hasta alcanzar los límites que hayas fijado. Esos límites son todo el arte de capturar bien:
- Por dónde va: las URL de inicio, los hostnames permitidos y las rutas incluidas/excluidas.
- Hasta dónde llega: la profundidad de enlaces (cuántos saltos desde el inicio) y el alcance de captura, un tope de páginas que va de Preview (100) a Large (5000).
- Con qué frecuencia se actualiza: una programación opcional, más una vida útil del contenido que vuelve a procesar las páginas automáticamente a medida que envejecen.
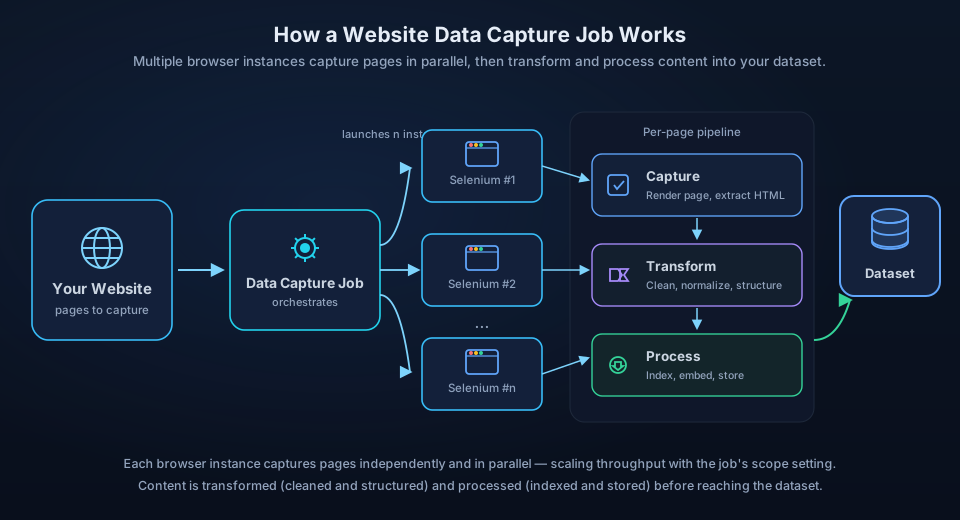
Por ejemplo, para convertir un manual de producto en conocimiento sin arrastrar la web de marketing, empezarías en
https://acme.com/docs/, restringirías el hostname aacme.com, incluirías solo*/docs/*, fijarías una profundidad de 3, elegirías el alcance Medium y programarías una recaptura semanal. Resultado: el manual se mantiene al día solo, y las páginas de inicio de sesión y de pago nunca se capturan.
Capturar no es la única forma de llenar un dataset
Un trabajo de captura de datos captura sitios web, pero también puedes subir ficheros o enviar contenido a través de la API de contenido (una función Enterprise). Las tres vías acaban en el mismo dataset y se buscan juntas, así que un dataset rara vez tiene una sola fuente.