Job di acquisizione dati
Un job di acquisizione dati è il modo principale per riempire un dataset a partire da un sito web. Lo punti su una o più pagine e ne raccoglie i contenuti in un dataset di memoria: niente copia-incolla, niente inserimento manuale, e può ripetersi secondo una pianificazione, così la tua conoscenza non resta mai indietro.
Come funziona un job di acquisizione dati
Procede verso l’esterno, pagina per pagina. Apre una pagina iniziale, ne estrae e salva i contenuti, legge i link presenti, poi segue i link scoperti verso le pagine successive, ripetendo finché non raggiunge i limiti che hai impostato. Quei limiti sono tutta l’arte di un’acquisizione ben fatta:
- Dove va: gli URL iniziali, gli hostname consentiti e i percorsi inclusi/esclusi.
- Quanto lontano: la profondità dei link (quanti salti dall’inizio) e l’ambito di acquisizione, un limite di pagine che va da Preview (100) a Large (5000).
- Quanto aggiornato: una pianificazione facoltativa, più una durata dei contenuti che rielabora automaticamente le pagine man mano che invecchiano.
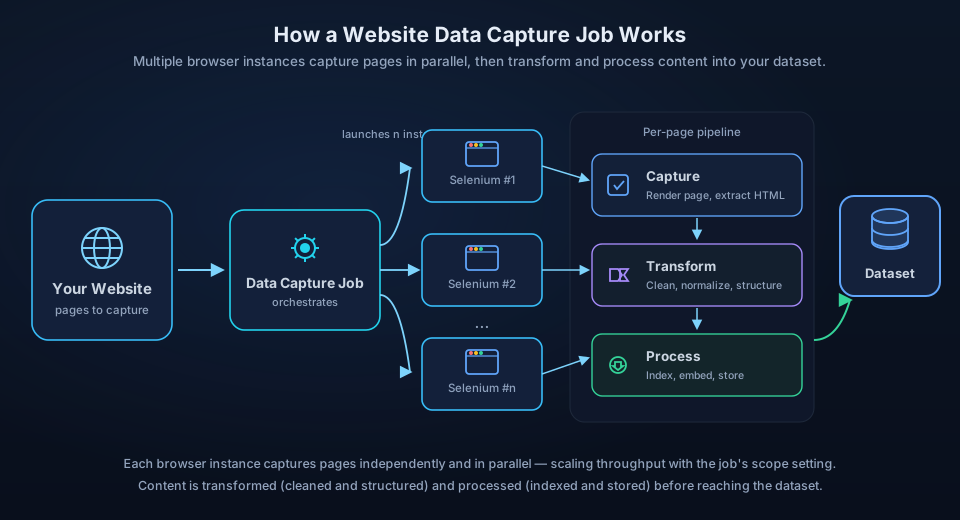
Ad esempio, per trasformare un manuale di prodotto in conoscenza senza trascinarti dietro il sito di marketing, partiresti da
https://acme.com/docs/, limiteresti l’hostname aacme.com, includeresti solo*/docs/*, imposteresti una profondità di 3, sceglieresti l’ambito Medium e pianificheresti una nuova acquisizione settimanale. Il risultato: il manuale resta aggiornato da solo e le pagine di login e di checkout non vengono mai acquisite.
L’acquisizione non è l’unico modo per riempire un dataset
Un job di acquisizione dati acquisisce siti web, ma puoi anche caricare file o inviare contenuti tramite la content API (una funzionalità Enterprise). Tutte e tre le fonti confluiscono nello stesso dataset e vengono cercate insieme: per questo un dataset raramente ha una sola fonte.
Approfondisci
- Personalizza il tuo scraper del sito web
- Pianifica un job di acquisizione dati
- Regola l’ambito di acquisizione