Cómo funcionan juntos
Las tres piezas forman un pipeline corto y en una sola dirección, con el dataset en el centro:
- Un trabajo de captura de datos escribe el contenido web capturado en un dataset de memoria.
- El dataset lo guarda y lo indexa para que se pueda buscar.
- Un asistente lee del dataset para responder preguntas.
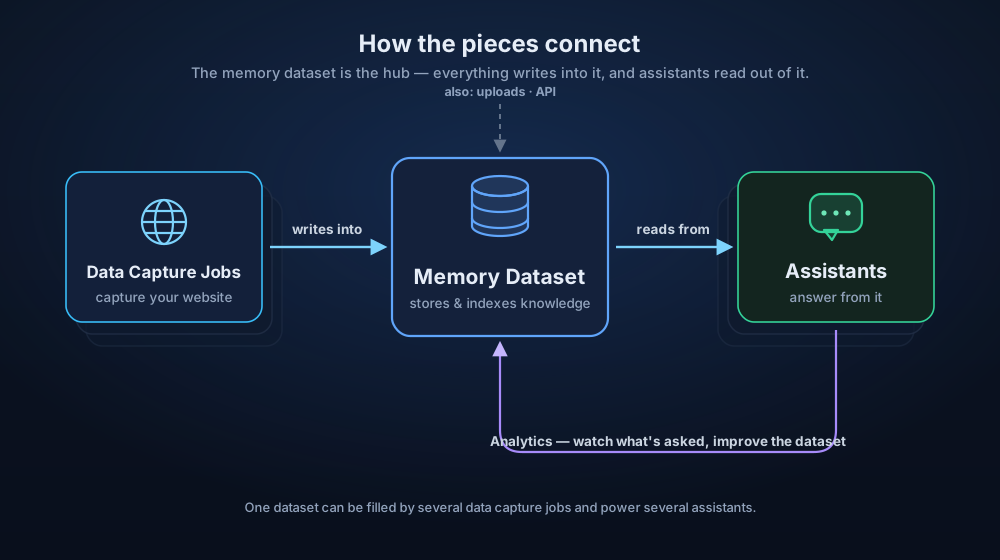
El dataset es el núcleo, y las relaciones se abren a cada lado: un dataset puede llenarse con varios trabajos de captura de datos (y subidas, y la API), y el mismo dataset puede dar servicio a varios asistentes. Cambia el conocimiento una vez, en el dataset, y todos los asistentes conectados a él mejoran en ese mismo momento.
Como el trabajo de captura de datos y el asistente solo se comunican a través del dataset, son independientes: puedes volver a ejecutar una captura para refrescar el contenido sin tocar el asistente, y reajustar el asistente sin volver a capturar.
El ciclo, de principio a fin
El pipeline se convierte realmente en un ciclo cuando un asistente está publicado y empiezas a escucharlo:
- Un trabajo de captura de datos llena el dataset a partir de tu centro de ayuda.
- El asistente responde a los visitantes basándose en ese contenido.
- La analítica muestra una pregunta que la gente repite y que responde mal.
- Añades el contenido que falta al dataset (o vuelves a capturar la página que cambió).
- El siguiente visitante ya recibe una respuesta sólida.
Ese ciclo de retroalimentación —observar qué se pregunta y cubrir el hueco en el dataset— es como un buen asistente mejora con el tiempo, sin tener que reconstruirlo nunca.
Profundiza
- Analítica
- Leer la analítica del asistente
- Programar un trabajo de captura de datos
- Analiza el contenido extraído