Ajuster la portée de capture
La portée indique à une tâche de capture de données où elle peut aller et quelle quantité prendre. Réglez-la correctement et elle capture exactement le contenu voulu — ni plus, ni moins.
Avant de commencer
- Ouvrez la tâche de site web.
- Sachez quelles pages doivent être incluses et lesquelles ne le doivent pas.
Étapes
- Ouvrez la page de détail de la tâche depuis Capture de données.
- Choisissez Edit properties pour ouvrir le formulaire de configuration.
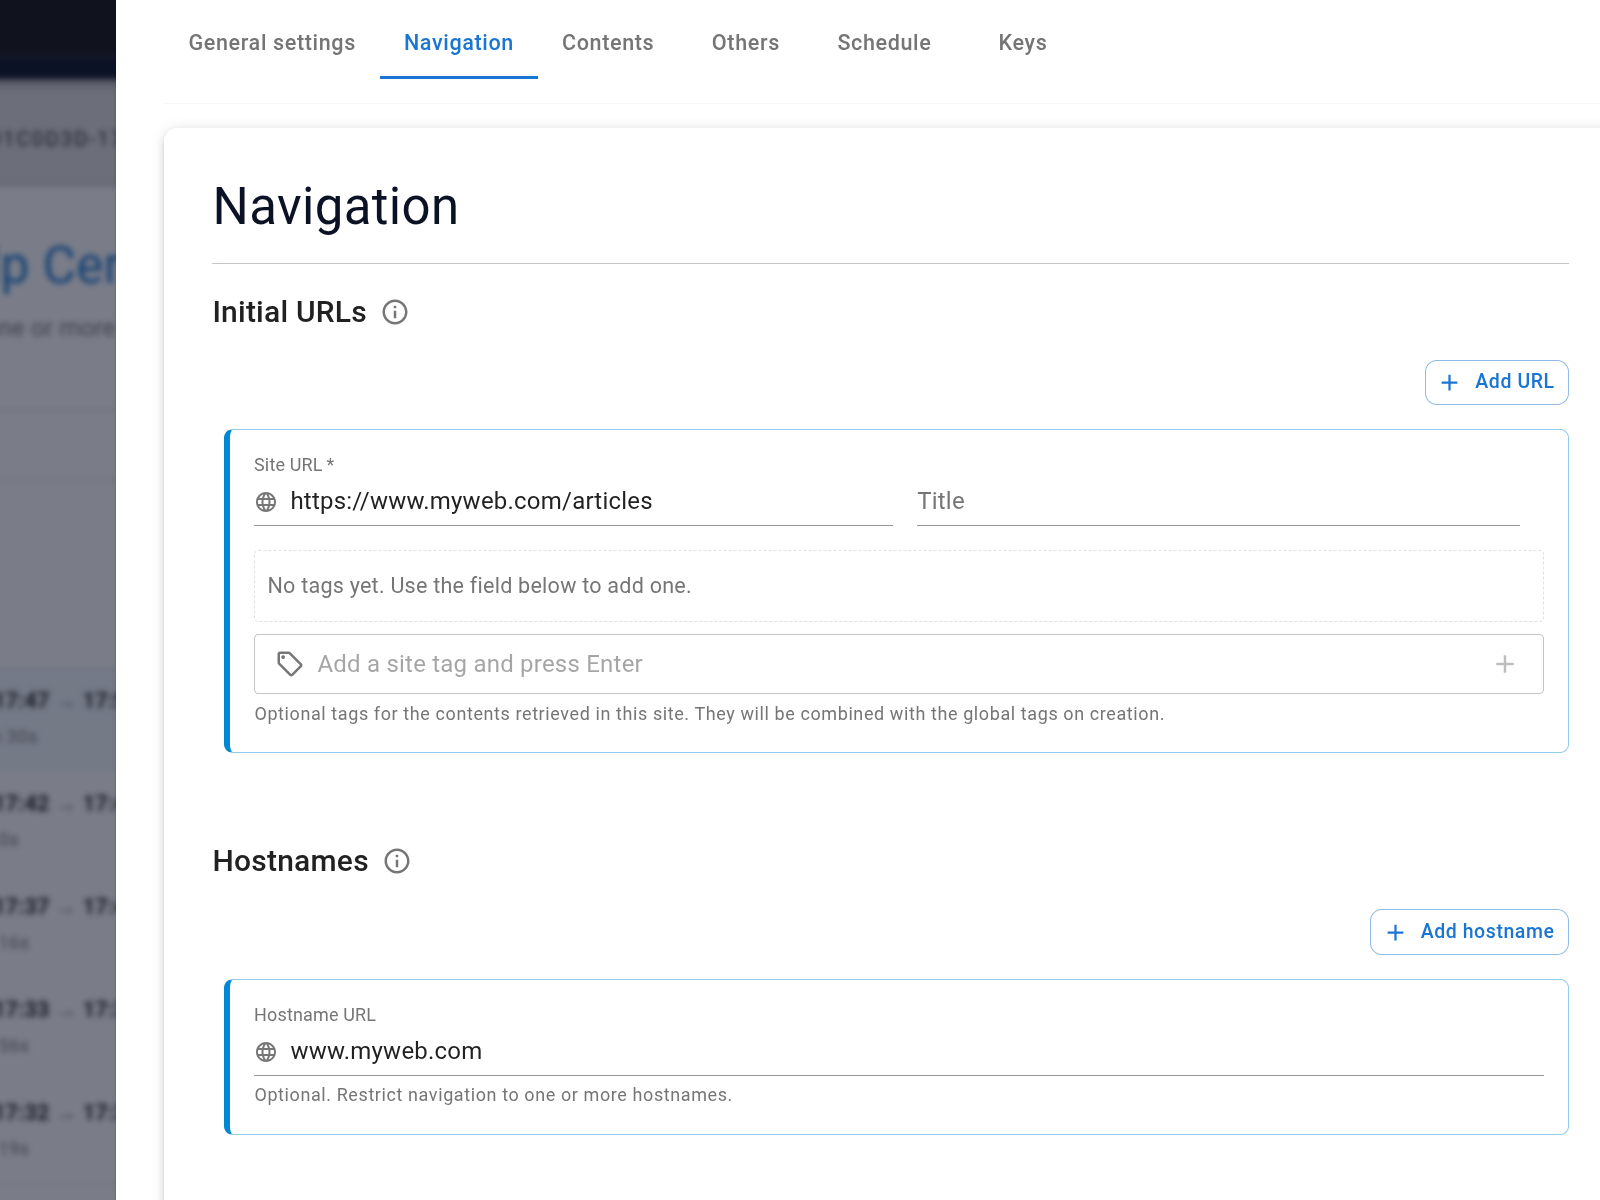
- Ouvrez les paramètres Navigation — c’est là que se trouvent tous les réglages de portée.
- Vérifiez les URL initiales (où commence la tâche) et la liste des noms d’hôte. La tâche ne suit que les liens correspondant à l’un des noms d’hôte autorisés : si votre site utilise des sous-domaines (par ex.
docs.acme.cometblog.acme.com), ajoutez chacun d’eux. - Ajoutez des chemins inclus pour limiter la tâche à des sections précises. Par exemple,
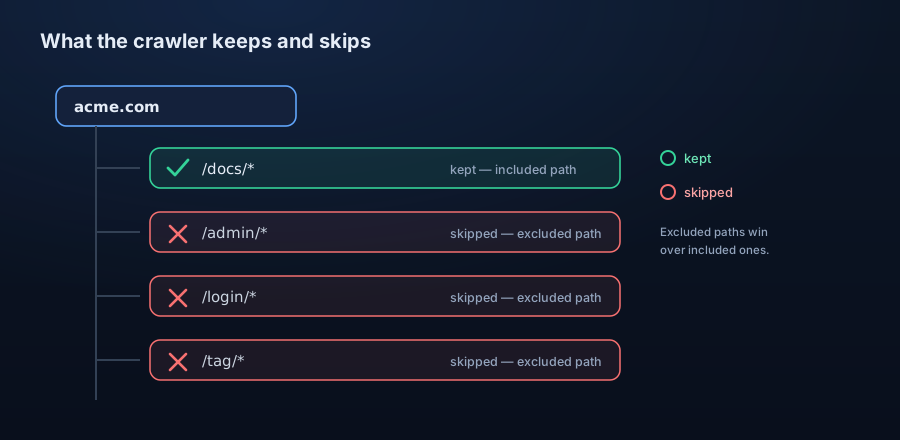
*/docs/*ne conserve que les pages dont l’URL contient/docs/. Si vous laissez ce champ vide, la tâche visite tout ce qui se trouve sur les noms d’hôte autorisés. - Ajoutez des chemins exclus pour les zones à ignorer — pages de connexion, panneaux d’administration, archives de tags, etc. Les chemins exclus sont prioritaires sur les chemins inclus : vous pouvez donc inclure une section large et y découper des exceptions.
- Définissez la profondeur d’exploration (le nombre de sauts de liens depuis les URL de départ que la tâche parcourra) et le nombre maximal de contenus (un plafond absolu du nombre de pages traitées en une exécution).
- Enregistrez la configuration mise à jour.
Exemples de règles de chemins
Les chemins inclus et exclus sont des motifs glob comparés au chemin de l’URL :
- Conserver une section : le chemin inclus */docs/* ne capture que la documentation et ignore tout le reste. - Éliminer le bruit : les chemins exclus */login/*, */cart/*, */tag/* écartent les pages de connexion, de paiement et d’archives de tags. - Découper une exception : incluez une section large et excluez un sous-chemin à l’intérieur — les chemins exclus l’emportent sur les chemins inclus.
Vérifier le résultat
Relancez la tâche, puis consultez les liens découverts et le contenu actualisé pour voir la nouvelle portée en action.
Dépannage
- Trop peu de contenu signifie généralement que la portée est trop étroite.
- Trop de contenu signifie qu’elle est trop large.
- N’oubliez pas qu’un chemin exclu peut discrètement annuler une page que vous pensiez avoir incluse.