Extraction de données par IA à partir de pages web
L’extraction doit commencer par une décision, pas par un robot d’exploration : de quel enregistrement avez-vous besoin au final ?
« Extraire des informations utiles » est trop vague pour être validé. Une demande exploitable précise les champs, les sources autorisées, la manière de représenter les valeurs manquantes et l’URL source qui étaye chaque enregistrement.
Définissez le résultat avant de collecter les pages
Pour un annuaire public de fournisseurs, l’enregistrement pourrait être :
| Champ | Type | Règle |
|---|---|---|
| supplierName | Texte | Utiliser la raison sociale ou le nom commercial affiché |
| category | Texte contrôlé | Faire correspondre à la liste de catégories convenue |
| location | Texte | Conserver la localité telle que publiée |
| certification | Liste | N’inclure que les certificats explicitement mentionnés |
| sourceUrl | URL | Conserver la page utilisée pour l’enregistrement |
| capturedAt | Date et heure | Consigner le moment où la source a été capturée |
Ne demandez pas à un modèle de déduire une certification ou une localisation que la page n’indique pas. Utilisez plutôt une valeur vide et un indicateur de vérification.
Capturez un ensemble de sources maîtrisé
Dans Seekdown, une tâche de capture de données d’un site web part d’URL sélectionnées et suit les liens dans les limites de nom d’hôte, de chemin, de profondeur et de nombre de pages. Utilisez les chemins inclus pour le répertoire pertinent et excluez la navigation qui produit des doublons ou des enregistrements sans rapport.
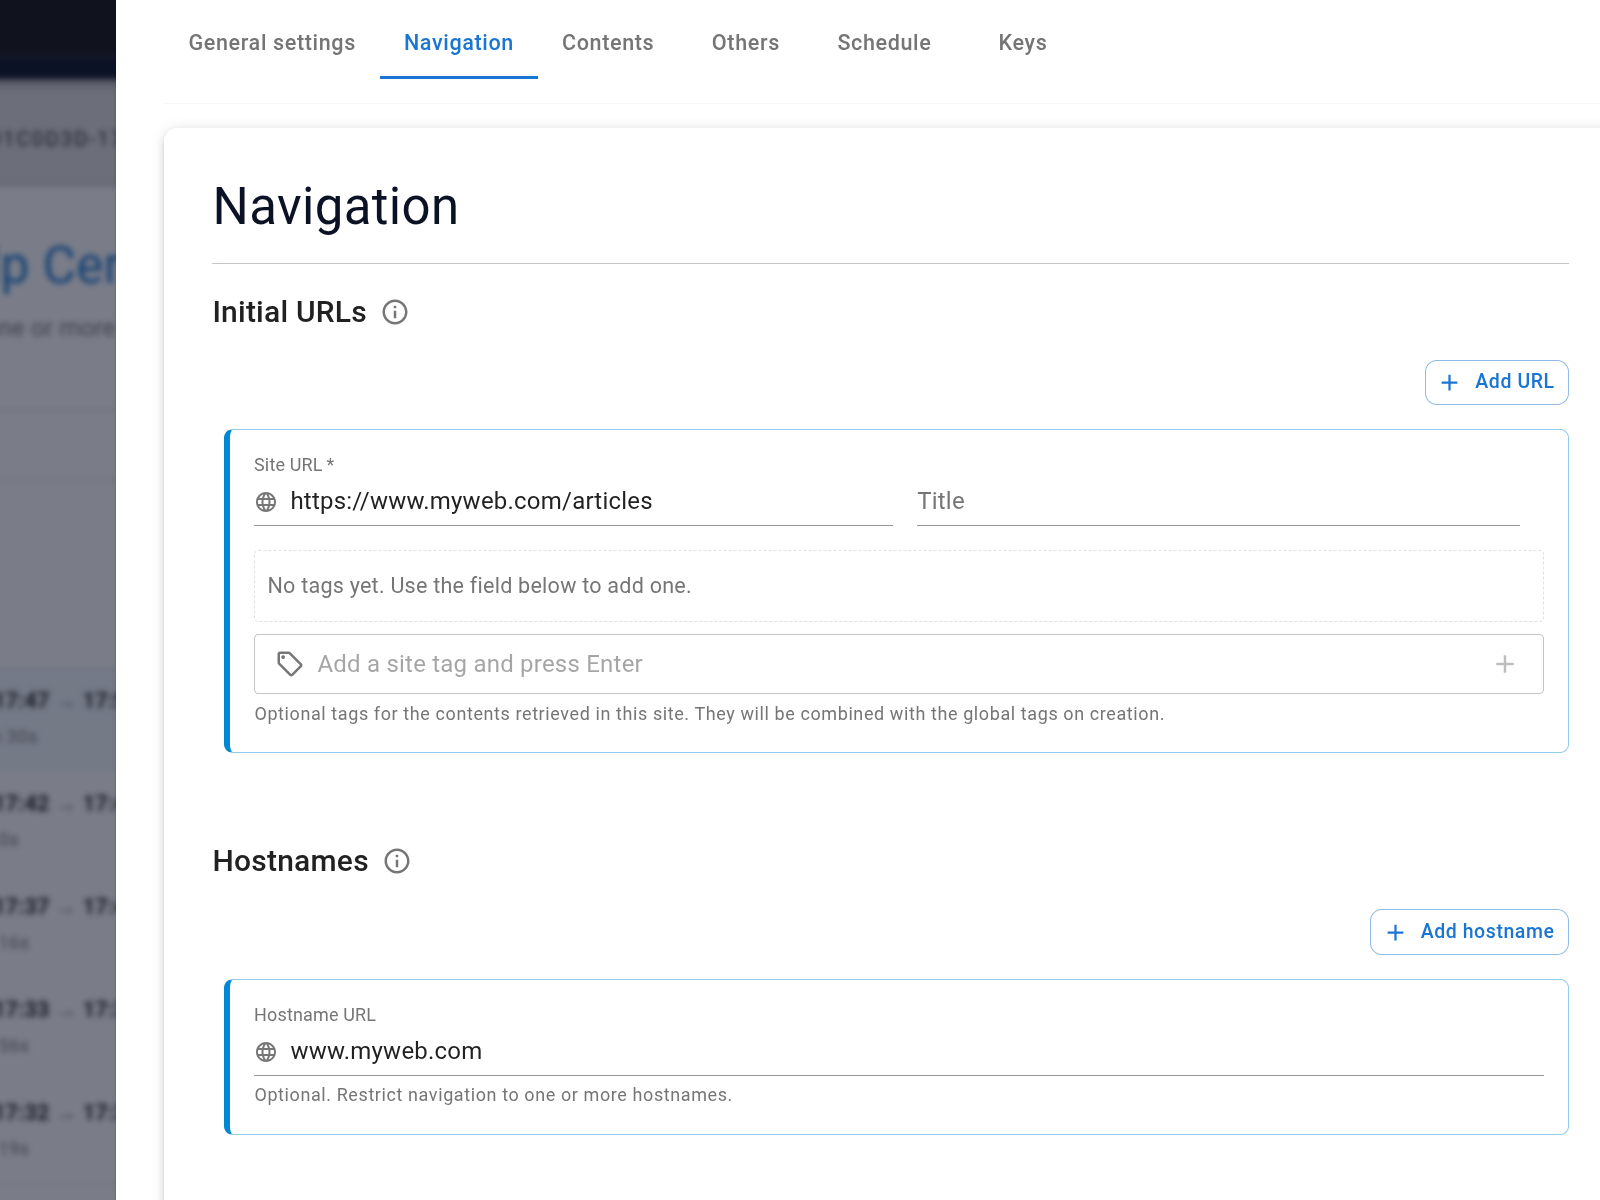
Lancez d’abord une petite capture. Dix pages représentatives révèleront les variations de modèles et les champs manquants plus rapidement qu’une exploration complète du domaine.
Inspectez les enregistrements capturés
Ouvrez le jeu de données mémoire et recherchez plusieurs noms de produits, titres ou valeurs connus. Vérifiez que le corps contient le texte nécessaire à l’extraction et que chaque enregistrement conserve son URL source.
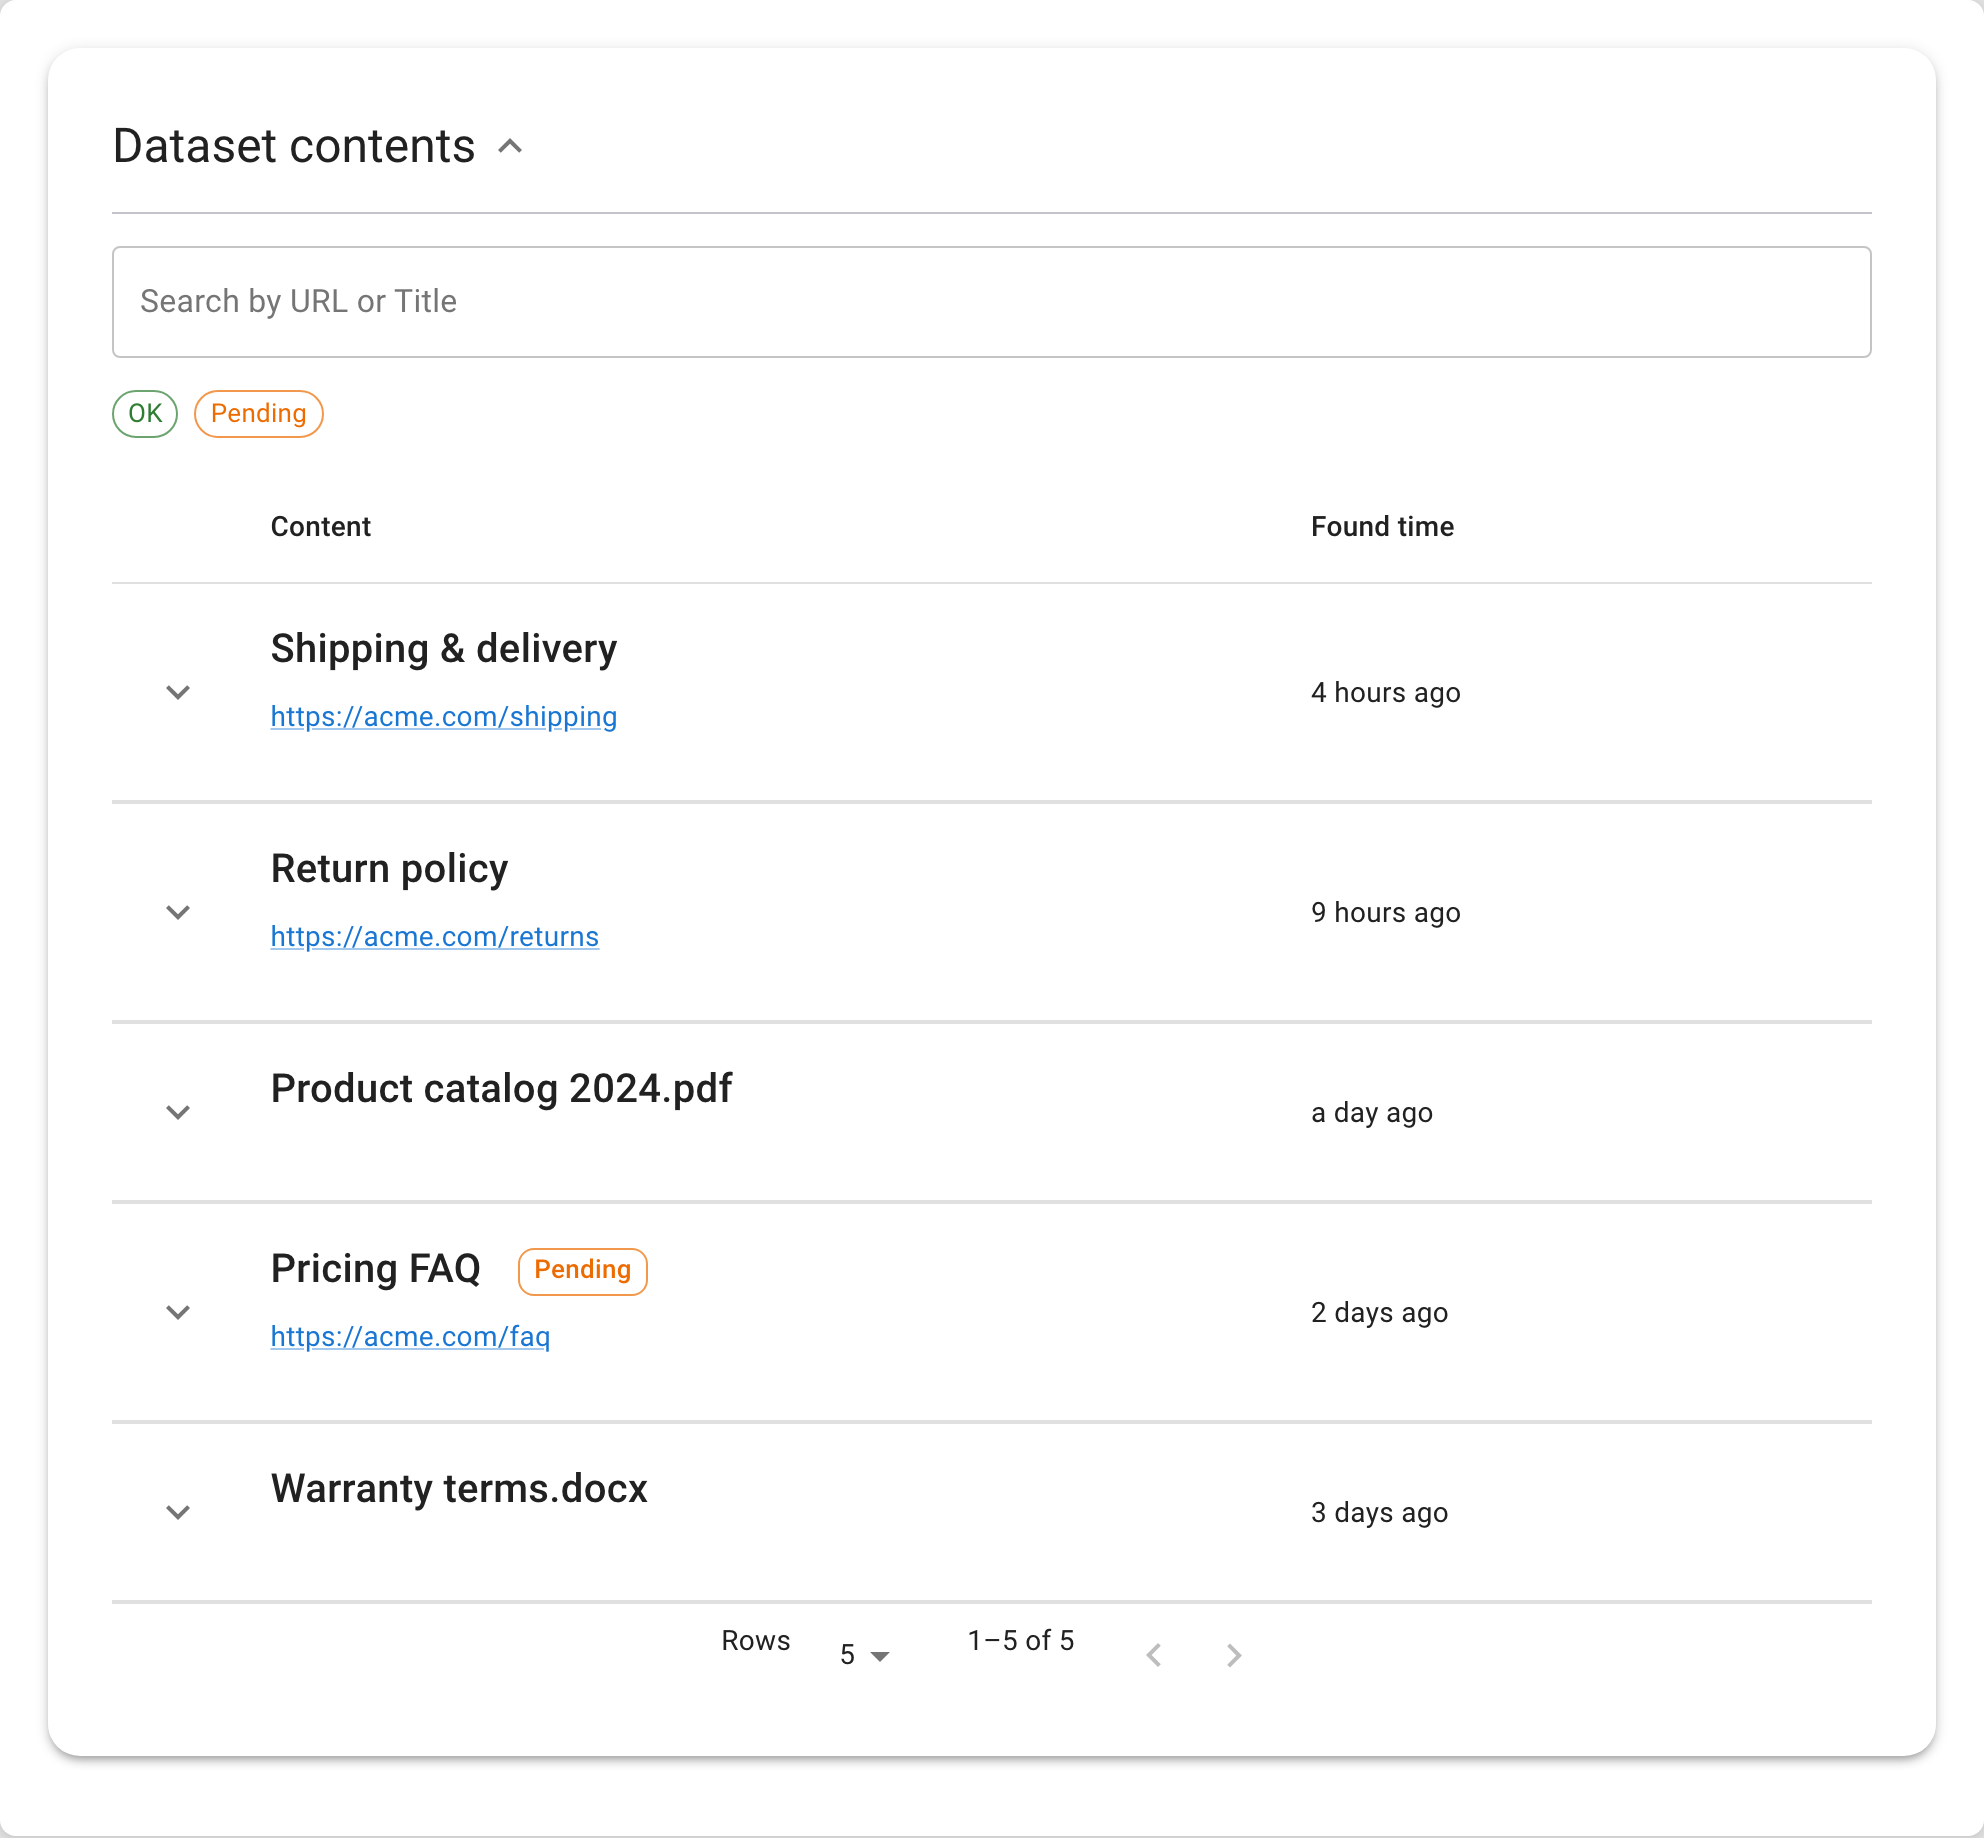
Si la valeur importante n’apparaît qu’après une connexion, dans une image ou dans un script que la capture ne récupère pas, changez de méthode de collecte plutôt que de combler le manque par des suppositions.
Validez les résultats structurés
Constituez un échantillon de vérification comprenant des pages courantes, incomplètes et atypiques.
| Vérification | Condition de réussite |
|---|---|
| Exhaustivité | Les champs obligatoires sont présents ou explicitement marqués comme manquants |
| Exactitude | Les valeurs correspondent à la source visible |
| Cohérence | Les valeurs équivalentes utilisent le même format |
| Provenance | Chaque enregistrement conserve son URL source |
| Fraîcheur | L’horodatage de capture correspond au besoin métier |
| Exceptions | Les pages utilisant un modèle différent sont signalées |
Calculez l’exactitude uniquement à partir d’un échantillon annoté et consignez sa taille. Par exemple, « 47 des 50 enregistrements vérifiés correspondaient à la source » est vérifiable ; « extraction très précise » ne l’est pas.
Exportez sans perdre la provenance
Les jeux de données Seekdown peuvent être exportés en CSV ou en JSON. Les jeux de données Enterprise peuvent également être exposés via un flux OData pour Excel Power Query ou Power BI. Les exports CSV comprennent des champs tels que la clé, le titre, le statut, l’URL, le corps, le résumé, les tags, la source et l’horodatage de découverte.
Conservez l’URL source et l’heure de capture dans les enregistrements en aval. Sans elles, un relecteur ne peut pas savoir si une valeur surprenante provient de la page, de la règle d’extraction ou d’une ancienne capture.