KI-Datenextraktion aus Webseiten
Eine Extraktion sollte mit einer Entscheidung beginnen, nicht mit einem Crawler: Welchen Datensatz brauchen Sie am Ende?
„Nützliche Informationen extrahieren“ ist zu vage, um es zu validieren. Eine umsetzbare Anforderung benennt die Felder, die zulässigen Quellen, wie fehlende Werte dargestellt werden und welche Quell-URL jeden Datensatz belegt.
Definieren Sie das Ergebnis, bevor Sie Seiten sammeln
Für ein öffentliches Lieferantenverzeichnis könnte der Datensatz so aussehen:
| Feld | Typ | Regel |
|---|---|---|
| supplierName | Text | Den angezeigten Firmen- oder Handelsnamen verwenden |
| category | Kontrollierter Text | Der vereinbarten Kategorienliste zuordnen |
| location | Text | Den Ort so übernehmen, wie er veröffentlicht ist |
| certification | Liste | Nur ausdrücklich genannte Zertifikate aufnehmen |
| sourceUrl | URL | Die für den Datensatz verwendete Seite festhalten |
| capturedAt | Datum und Uhrzeit | Festhalten, wann die Quelle erfasst wurde |
Lassen Sie ein Modell keine Zertifizierung oder keinen Standort ableiten, den die Seite nicht nennt. Verwenden Sie stattdessen einen leeren Wert und eine Prüfmarkierung.
Erfassen Sie eine kontrollierte Quellenauswahl
In Seekdown startet ein Website-Datenerfassungsjob bei ausgewählten URLs und folgt Links innerhalb seiner Grenzen für Hostname, Pfad, Tiefe und Seitenzahl. Nehmen Sie die Pfade des relevanten Verzeichnisses auf und schließen Sie Navigation aus, die Duplikate oder fremde Datensätze erzeugt.
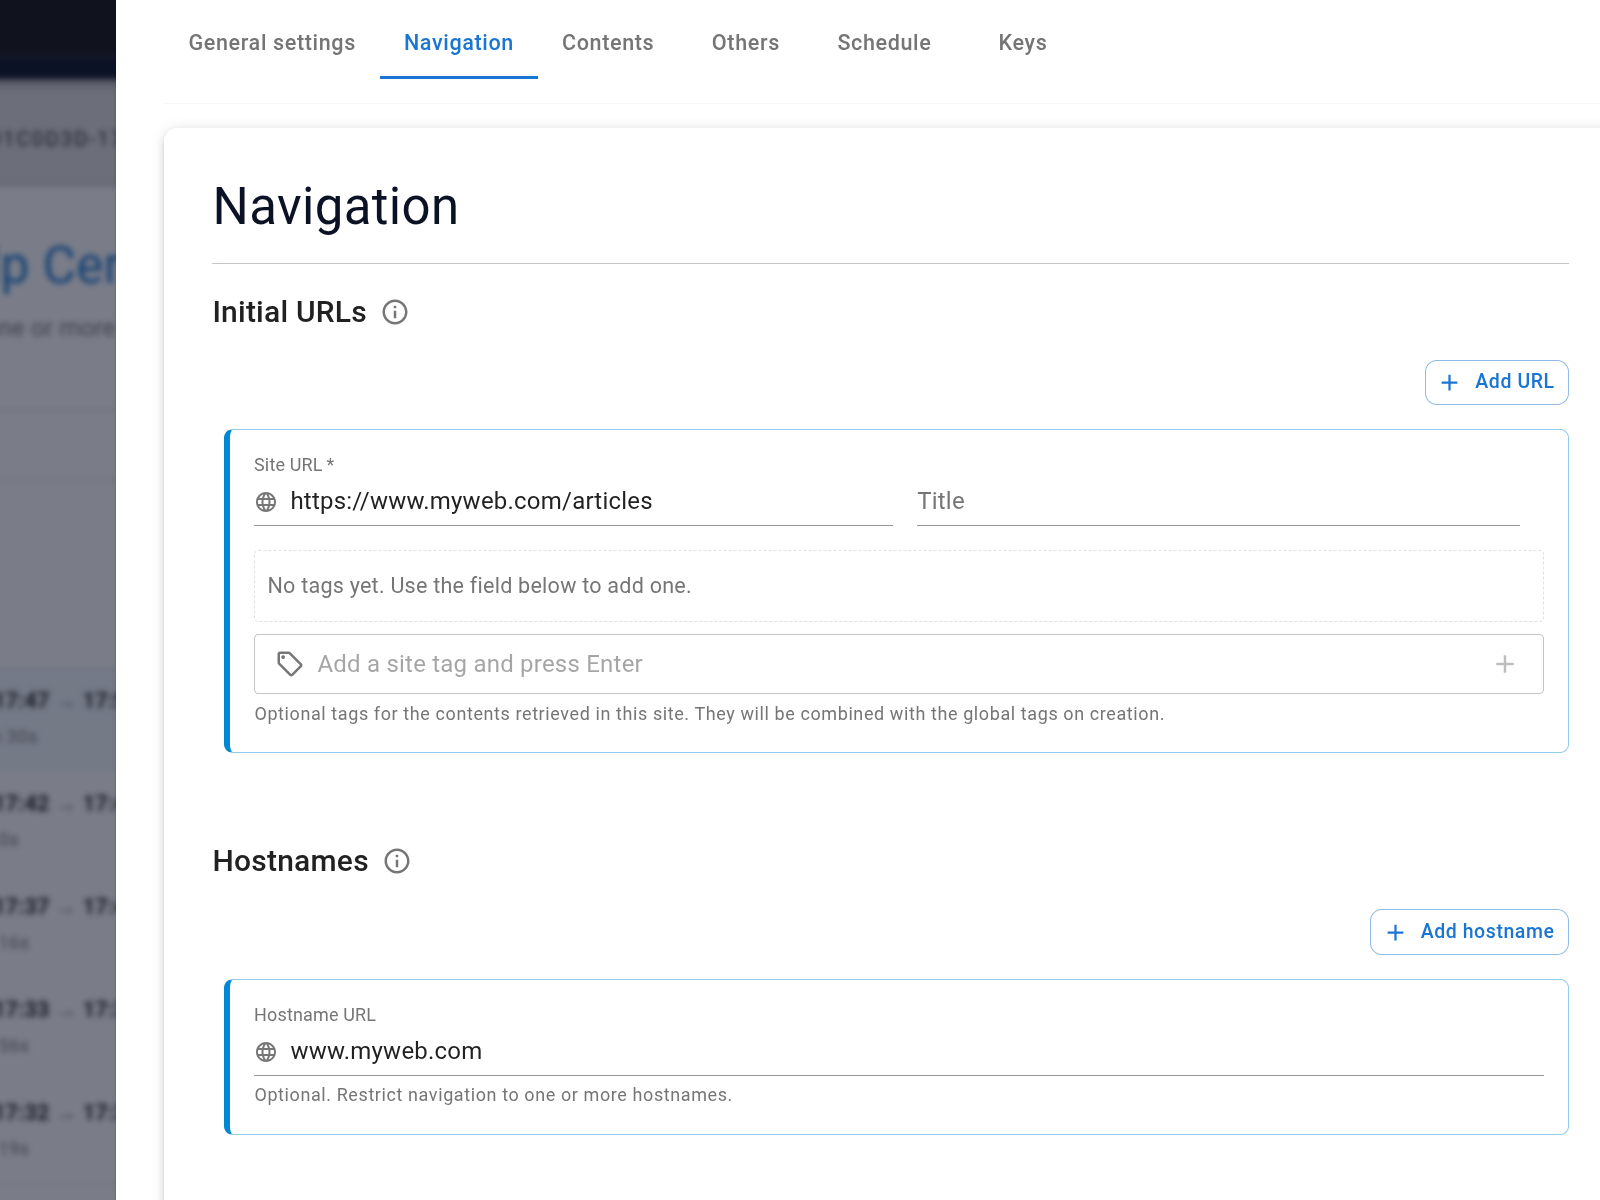
Führen Sie zuerst eine kleine Erfassung durch. Zehn repräsentative Seiten zeigen Vorlagenvarianten und fehlende Felder schneller als ein Lauf über die gesamte Domain.
Prüfen Sie die erfassten Datensätze
Öffnen Sie den Memory-Datensatz und suchen Sie nach einigen bekannten Produktnamen, Überschriften oder Werten. Prüfen Sie, ob der Inhalt den für die Extraktion nötigen Text enthält und jeder Datensatz seine Quell-URL behält.
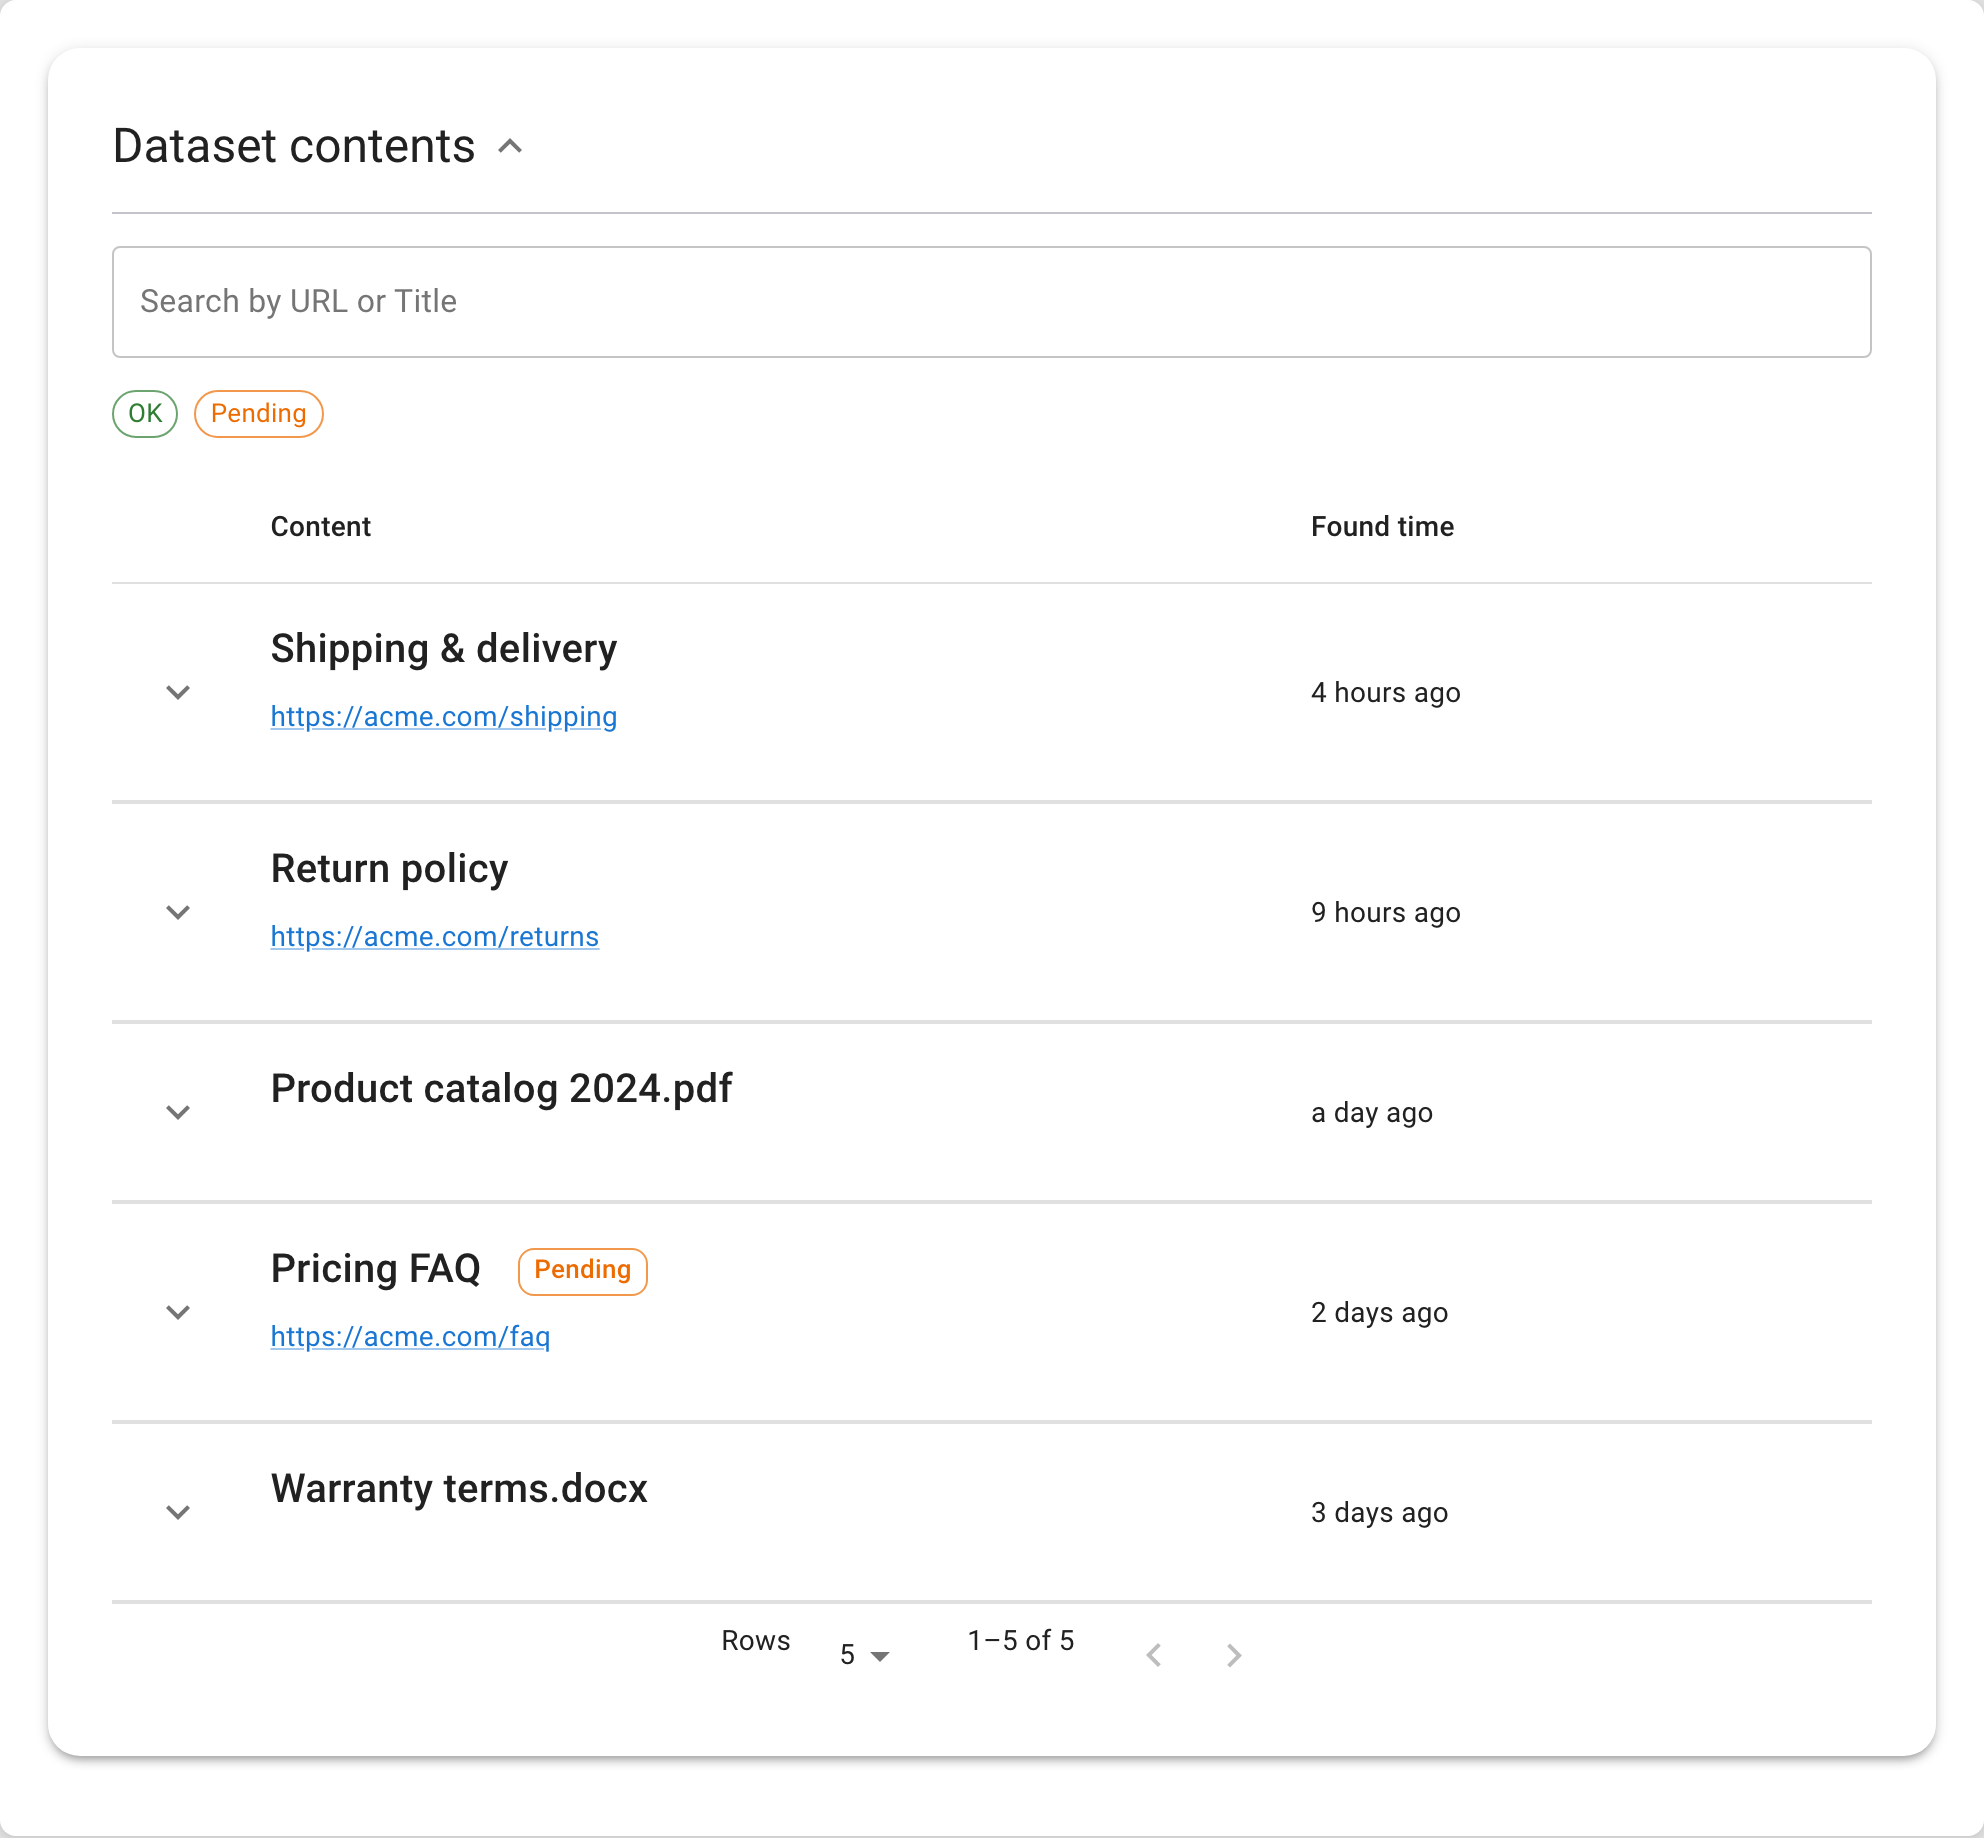
Erscheint der wichtige Wert erst nach einem Login, in einem Bild oder in einem Skript, das die Erfassung nicht abruft, ändern Sie die Quellmethode, statt die Lücke durch Raten zu füllen.
Validieren Sie die strukturierten Ergebnisse
Stellen Sie eine Prüfstichprobe aus typischen, lückenhaften und ungewöhnlichen Seiten zusammen.
| Prüfung | Bestanden, wenn |
|---|---|
| Vollständigkeit | Pflichtfelder vorhanden oder ausdrücklich als fehlend markiert sind |
| Genauigkeit | Die Werte mit der sichtbaren Quelle übereinstimmen |
| Konsistenz | Gleichwertige Werte dasselbe Format haben |
| Herkunft | Jeder Datensatz seine Quell-URL behält |
| Aktualität | Der Erfassungszeitpunkt zum geschäftlichen Bedarf passt |
| Ausnahmen | Seiten mit abweichender Vorlage markiert sind |
Berechnen Sie die Genauigkeit nur anhand einer gekennzeichneten Stichprobe und notieren Sie deren Größe. „47 von 50 geprüften Datensätzen stimmten mit der Quelle überein“ ist zum Beispiel nachprüfbar; „hochpräzise Extraktion“ ist es nicht.
Exportieren Sie, ohne die Herkunft zu verlieren
Seekdown-Datensätze lassen sich als CSV oder JSON exportieren. Enterprise-Datensätze können zusätzlich über einen OData-Feed für Excel Power Query oder Power BI bereitgestellt werden. CSV-Exporte enthalten Felder wie Schlüssel, Titel, Status, URL, Inhalt, Zusammenfassung, Tags, Quelle und Zeitpunkt der Entdeckung.
Behalten Sie Quell-URL und Erfassungszeit in den nachgelagerten Datensätzen. Ohne sie kann ein Prüfer nicht erkennen, ob ein überraschender Wert von der Seite, der Extraktionsregel oder einer alten Erfassung stammt.