Estrazione dati con IA dalle pagine web
L’estrazione deve partire da una decisione, non da un crawler: quale record ti serve alla fine?
"Estrarre informazioni utili" è troppo vago per essere convalidato. Una richiesta praticabile indica i campi, le fonti consentite, come rappresentare i valori mancanti e quale URL sorgente sostiene ogni record.
Definisci l’output prima di raccogliere le pagine
Per un elenco pubblico di fornitori, il record potrebbe essere:
| Campo | Tipo | Regola |
|---|---|---|
| supplierName | Testo | Usa la ragione sociale o il nome commerciale mostrato |
| category | Testo controllato | Mappa sull’elenco di categorie concordato |
| location | Testo | Mantieni la località così come pubblicata |
| certification | Lista | Includi solo le certificazioni dichiarate esplicitamente |
| sourceUrl | URL | Conserva la pagina usata per il record |
| capturedAt | Data e ora | Registra quando la fonte è stata acquisita |
Non chiedere a un modello di dedurre una certificazione o una località che la pagina non indica. Usa invece un valore vuoto e un flag di revisione.
Acquisisci un insieme di fonti controllato
In Seekdown, un job di acquisizione dati da sito web parte da URL selezionati e segue i link entro i limiti di hostname, percorso, profondità e numero di pagine. Usa i percorsi inclusi per la sezione rilevante ed escludi la navigazione che produce duplicati o record non pertinenti.
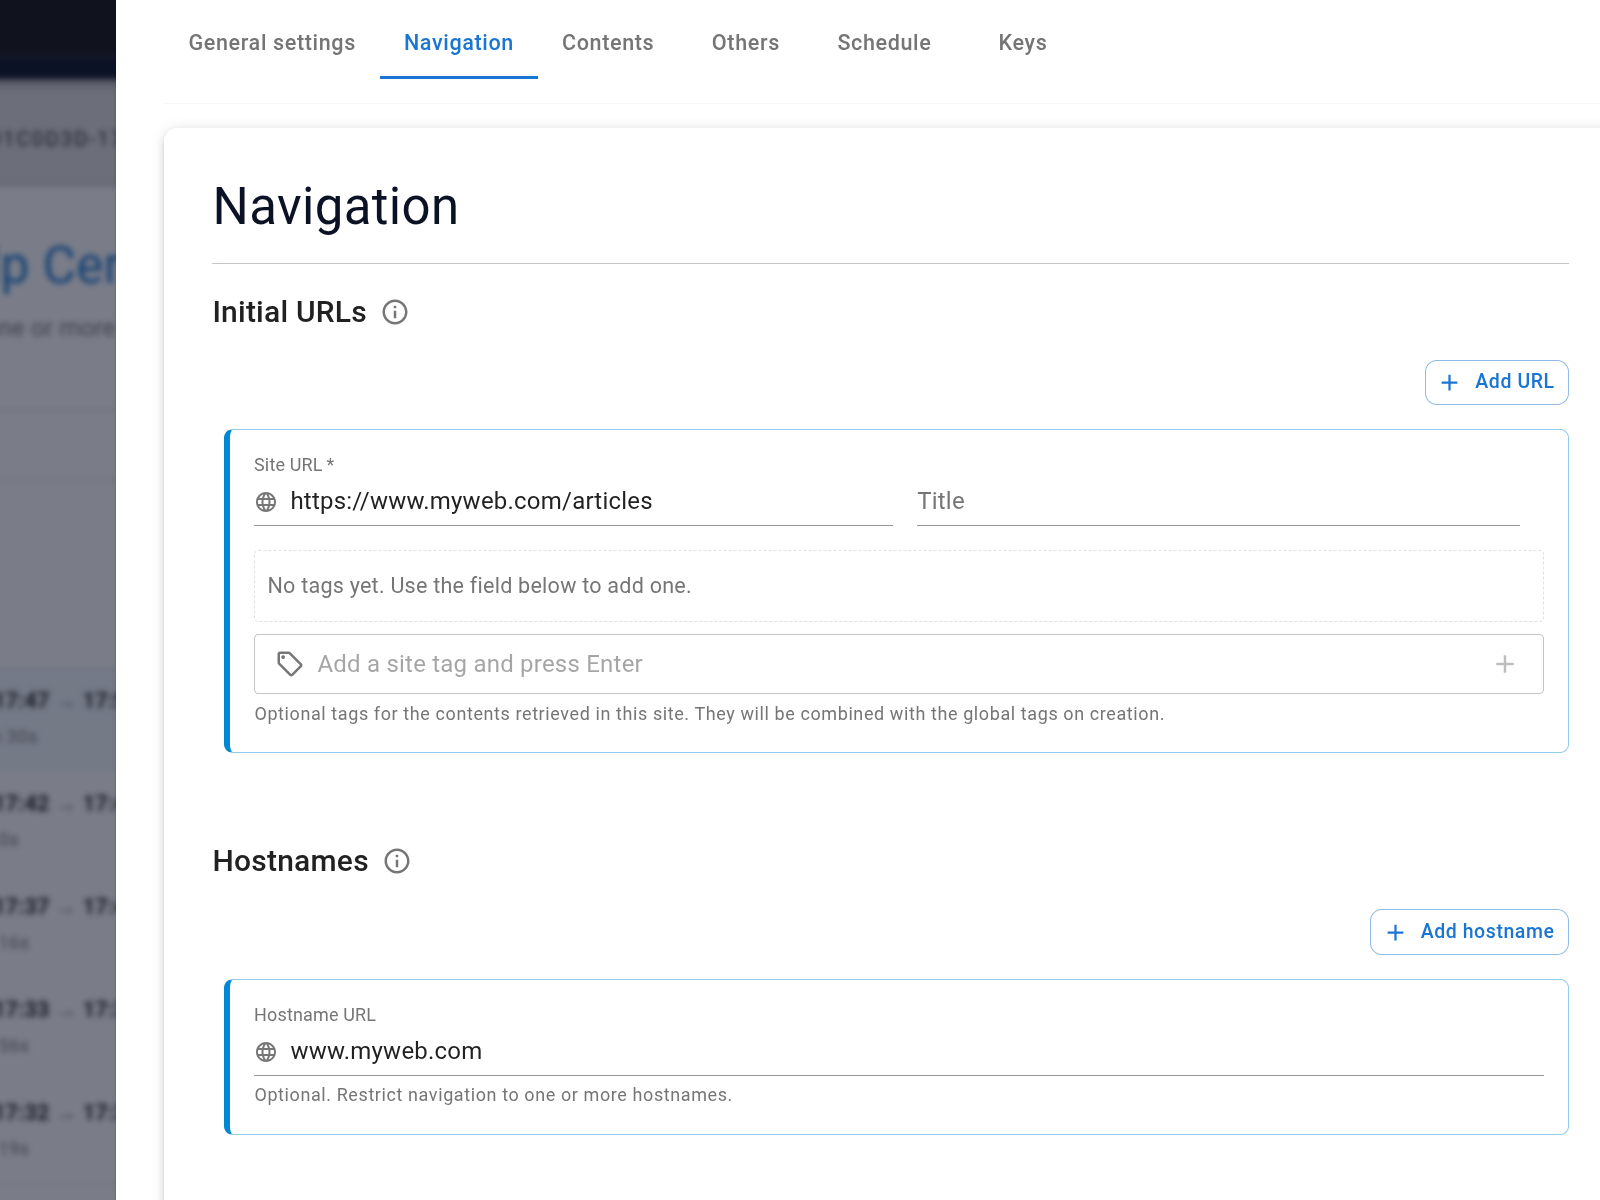
Esegui prima un’acquisizione ridotta. Dieci pagine rappresentative rivelano le varianti di template e i campi mancanti più rapidamente di una scansione dell’intero dominio.
Controlla i record acquisiti
Apri il dataset di memoria e cerca alcuni nomi di prodotto, titoli o valori noti. Verifica che il corpo contenga il testo necessario per l’estrazione e che ogni record conservi il proprio URL sorgente.
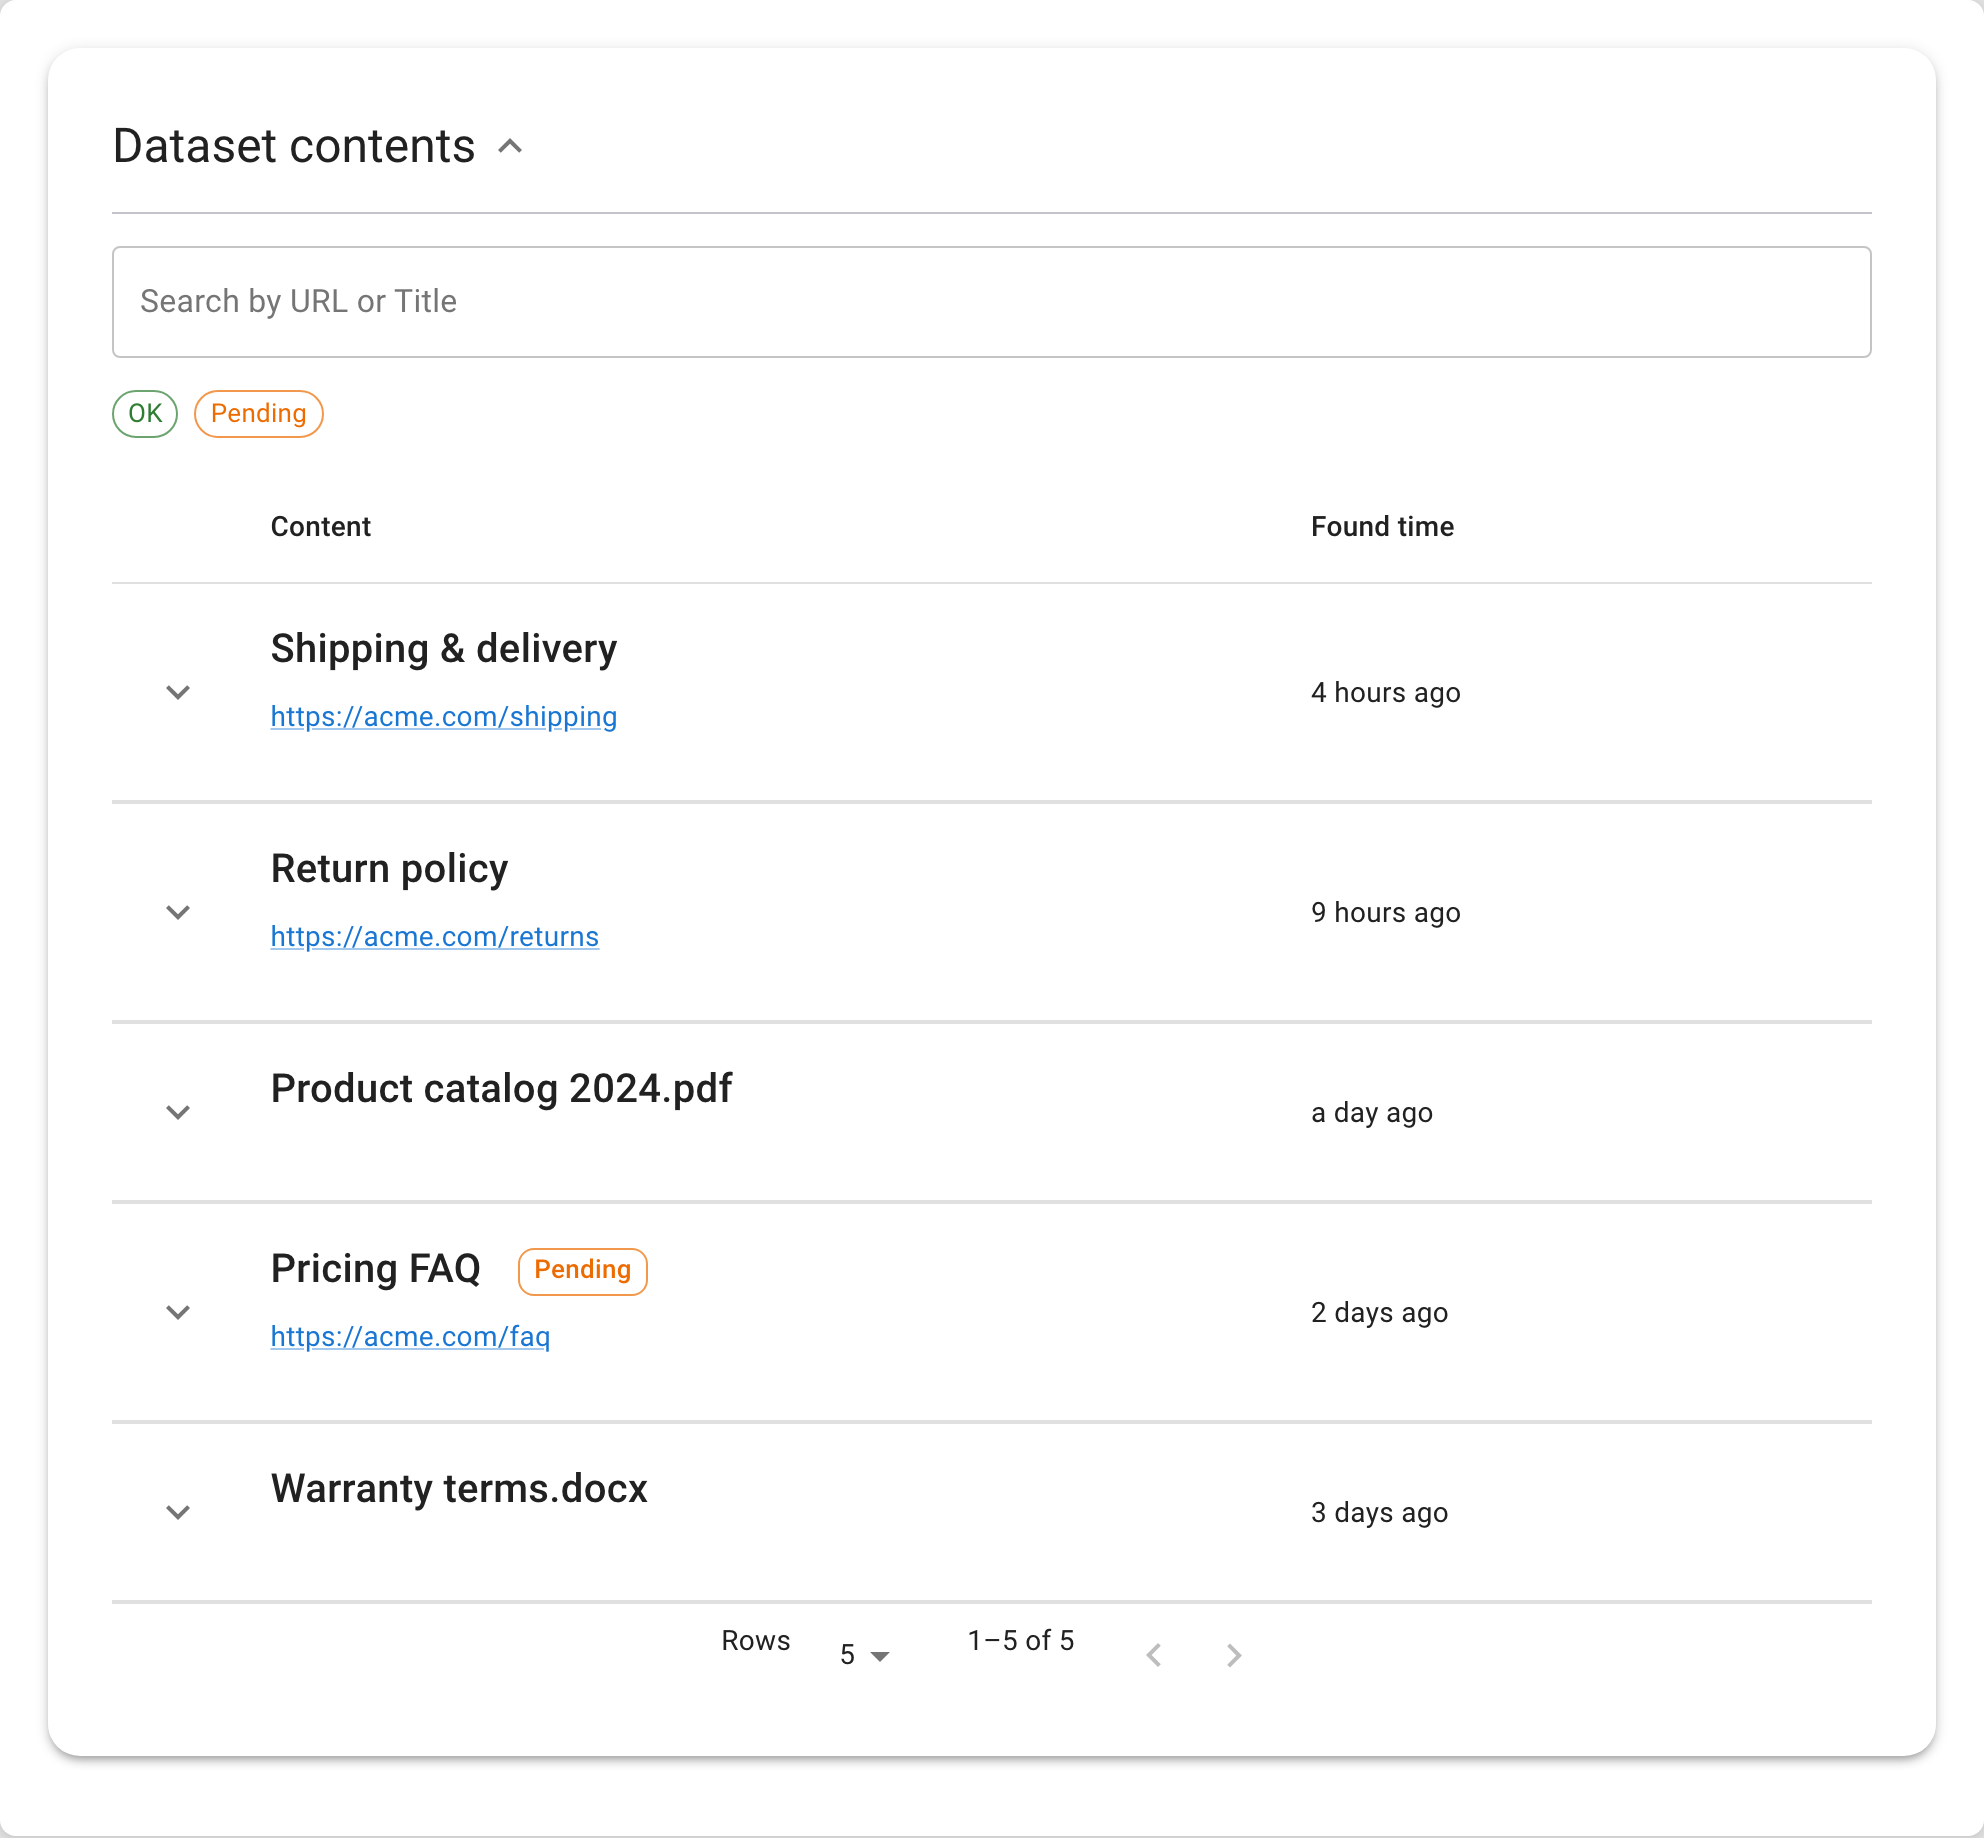
Se il valore importante compare solo dopo un login, dentro un’immagine o in uno script che l’acquisizione non recupera, cambia il metodo di acquisizione invece di colmare la lacuna tirando a indovinare.
Convalida i risultati strutturati
Crea un campione di revisione che includa pagine comuni, scarne e insolite.
| Controllo | Condizione per superarlo |
|---|---|
| Completezza | I campi obbligatori sono presenti o esplicitamente segnati come mancanti |
| Accuratezza | I valori corrispondono alla fonte visibile |
| Coerenza | I valori equivalenti usano lo stesso formato |
| Provenienza | Ogni record conserva il proprio URL sorgente |
| Aggiornamento | La data di acquisizione è adeguata all’esigenza di business |
| Eccezioni | Le pagine con un template diverso sono segnalate |
Calcola l’accuratezza solo su un campione etichettato e registrane la dimensione. Ad esempio, "47 dei 50 record revisionati corrispondevano alla fonte" è verificabile; "estrazione altamente accurata" no.
Esporta senza perdere la provenienza
I dataset Seekdown possono essere esportati in CSV o JSON. I dataset Enterprise possono anche essere esposti tramite un feed OData per Power Query di Excel o Power BI. Le esportazioni CSV includono campi come chiave, titolo, stato, URL, corpo, riepilogo, tag, fonte e data di rilevamento.
Conserva l’URL sorgente e la data di acquisizione nei record a valle. Senza questi dati, un revisore non può capire se un valore sorprendente provenga dalla pagina, dalla regola di estrazione o da un’acquisizione vecchia.