Extracción de datos de páginas web con IA
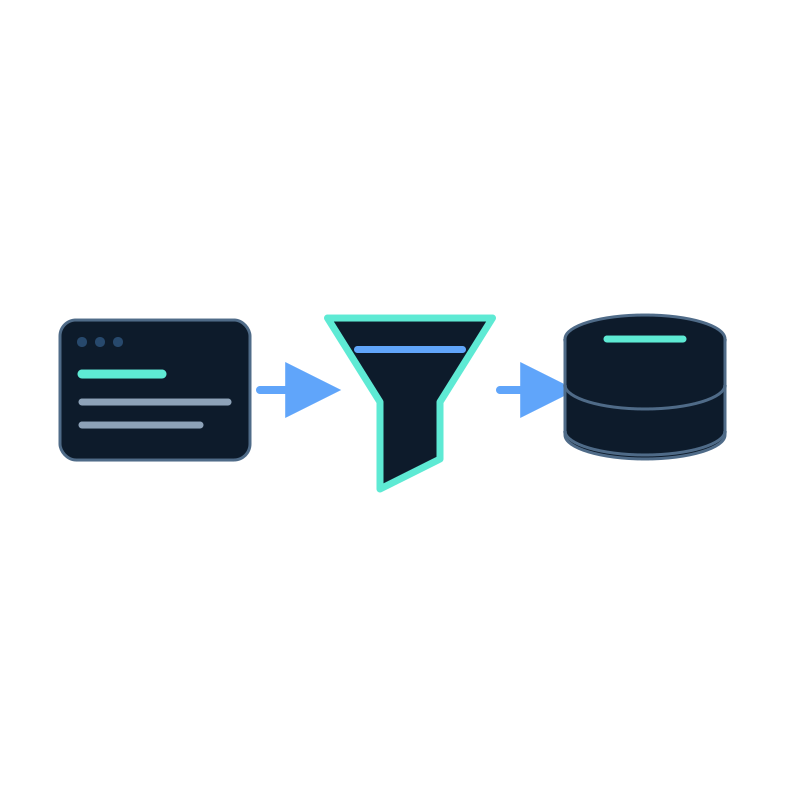
La extracción debe empezar con una decisión, no con un rastreador: ¿qué registro necesitas al final?
"Extraer información útil" es demasiado vago para poder validarlo. Una petición viable indica los campos, las fuentes permitidas, cómo se representan los valores que faltan y qué URL de origen respalda cada registro.
Define el resultado antes de recopilar páginas
Para un directorio público de proveedores, el registro podría ser:
| Campo | Tipo | Regla |
|---|---|---|
| supplierName | Texto | Usa la razón social o el nombre comercial mostrado |
| category | Texto controlado | Asígnalo a la lista de categorías acordada |
| location | Texto | Conserva la localidad tal como está publicada |
| certification | Lista | Incluye solo los certificados indicados de forma explícita |
| sourceUrl | URL | Guarda la página usada para el registro |
| capturedAt | Fecha y hora | Registra cuándo se capturó la fuente |
No pidas a un modelo que deduzca una certificación o una ubicación que la página no indica. En su lugar, usa un valor vacío y una marca de revisión.
Captura un conjunto de fuentes controlado
En Seekdown, un trabajo de captura de datos web parte de las URL seleccionadas y sigue los enlaces dentro de sus límites de nombre de host, ruta, profundidad y número de páginas. Usa rutas incluidas para el directorio relevante y excluye la navegación que genera duplicados o registros no relacionados.
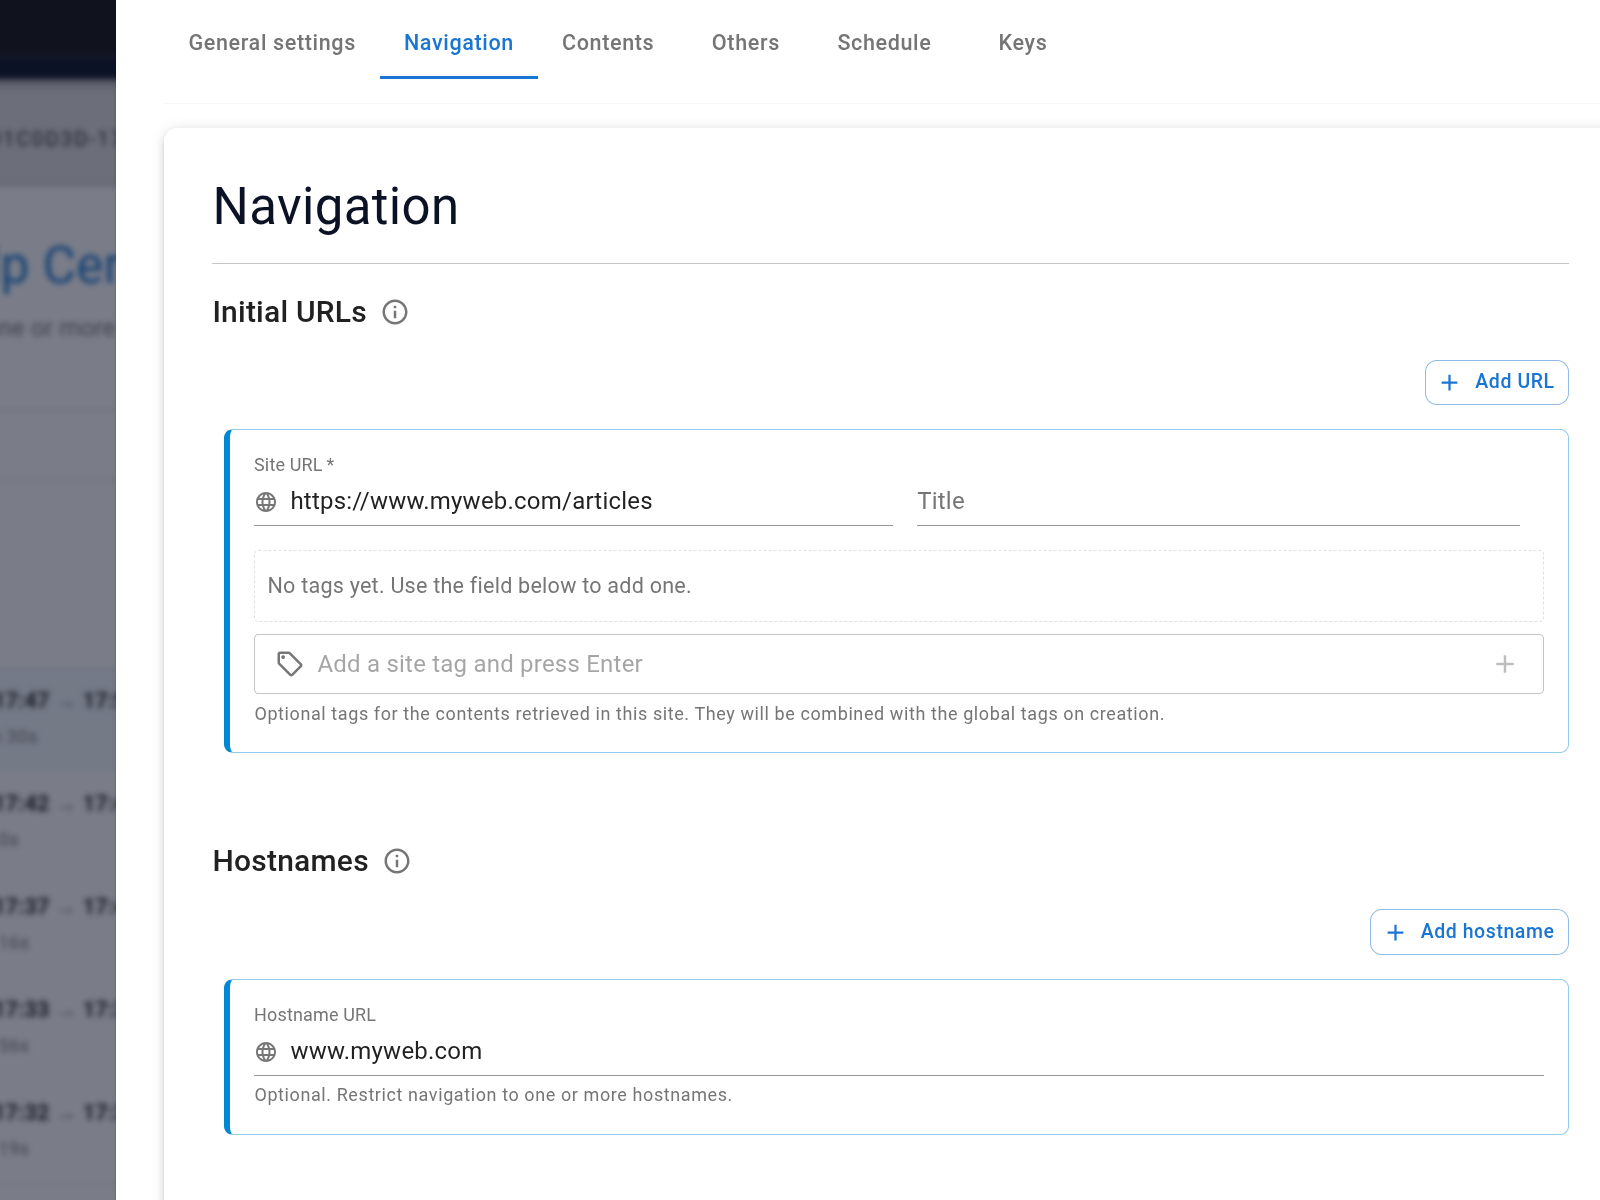
Haz primero una captura pequeña. Diez páginas representativas revelan las variaciones de plantilla y los campos que faltan más rápido que un rastreo de todo el dominio.
Revisa los registros capturados
Abre el dataset de memoria y busca varios nombres de producto, encabezados o valores que conozcas. Comprueba que el cuerpo contiene el texto necesario para la extracción y que cada registro conserva su URL de origen.
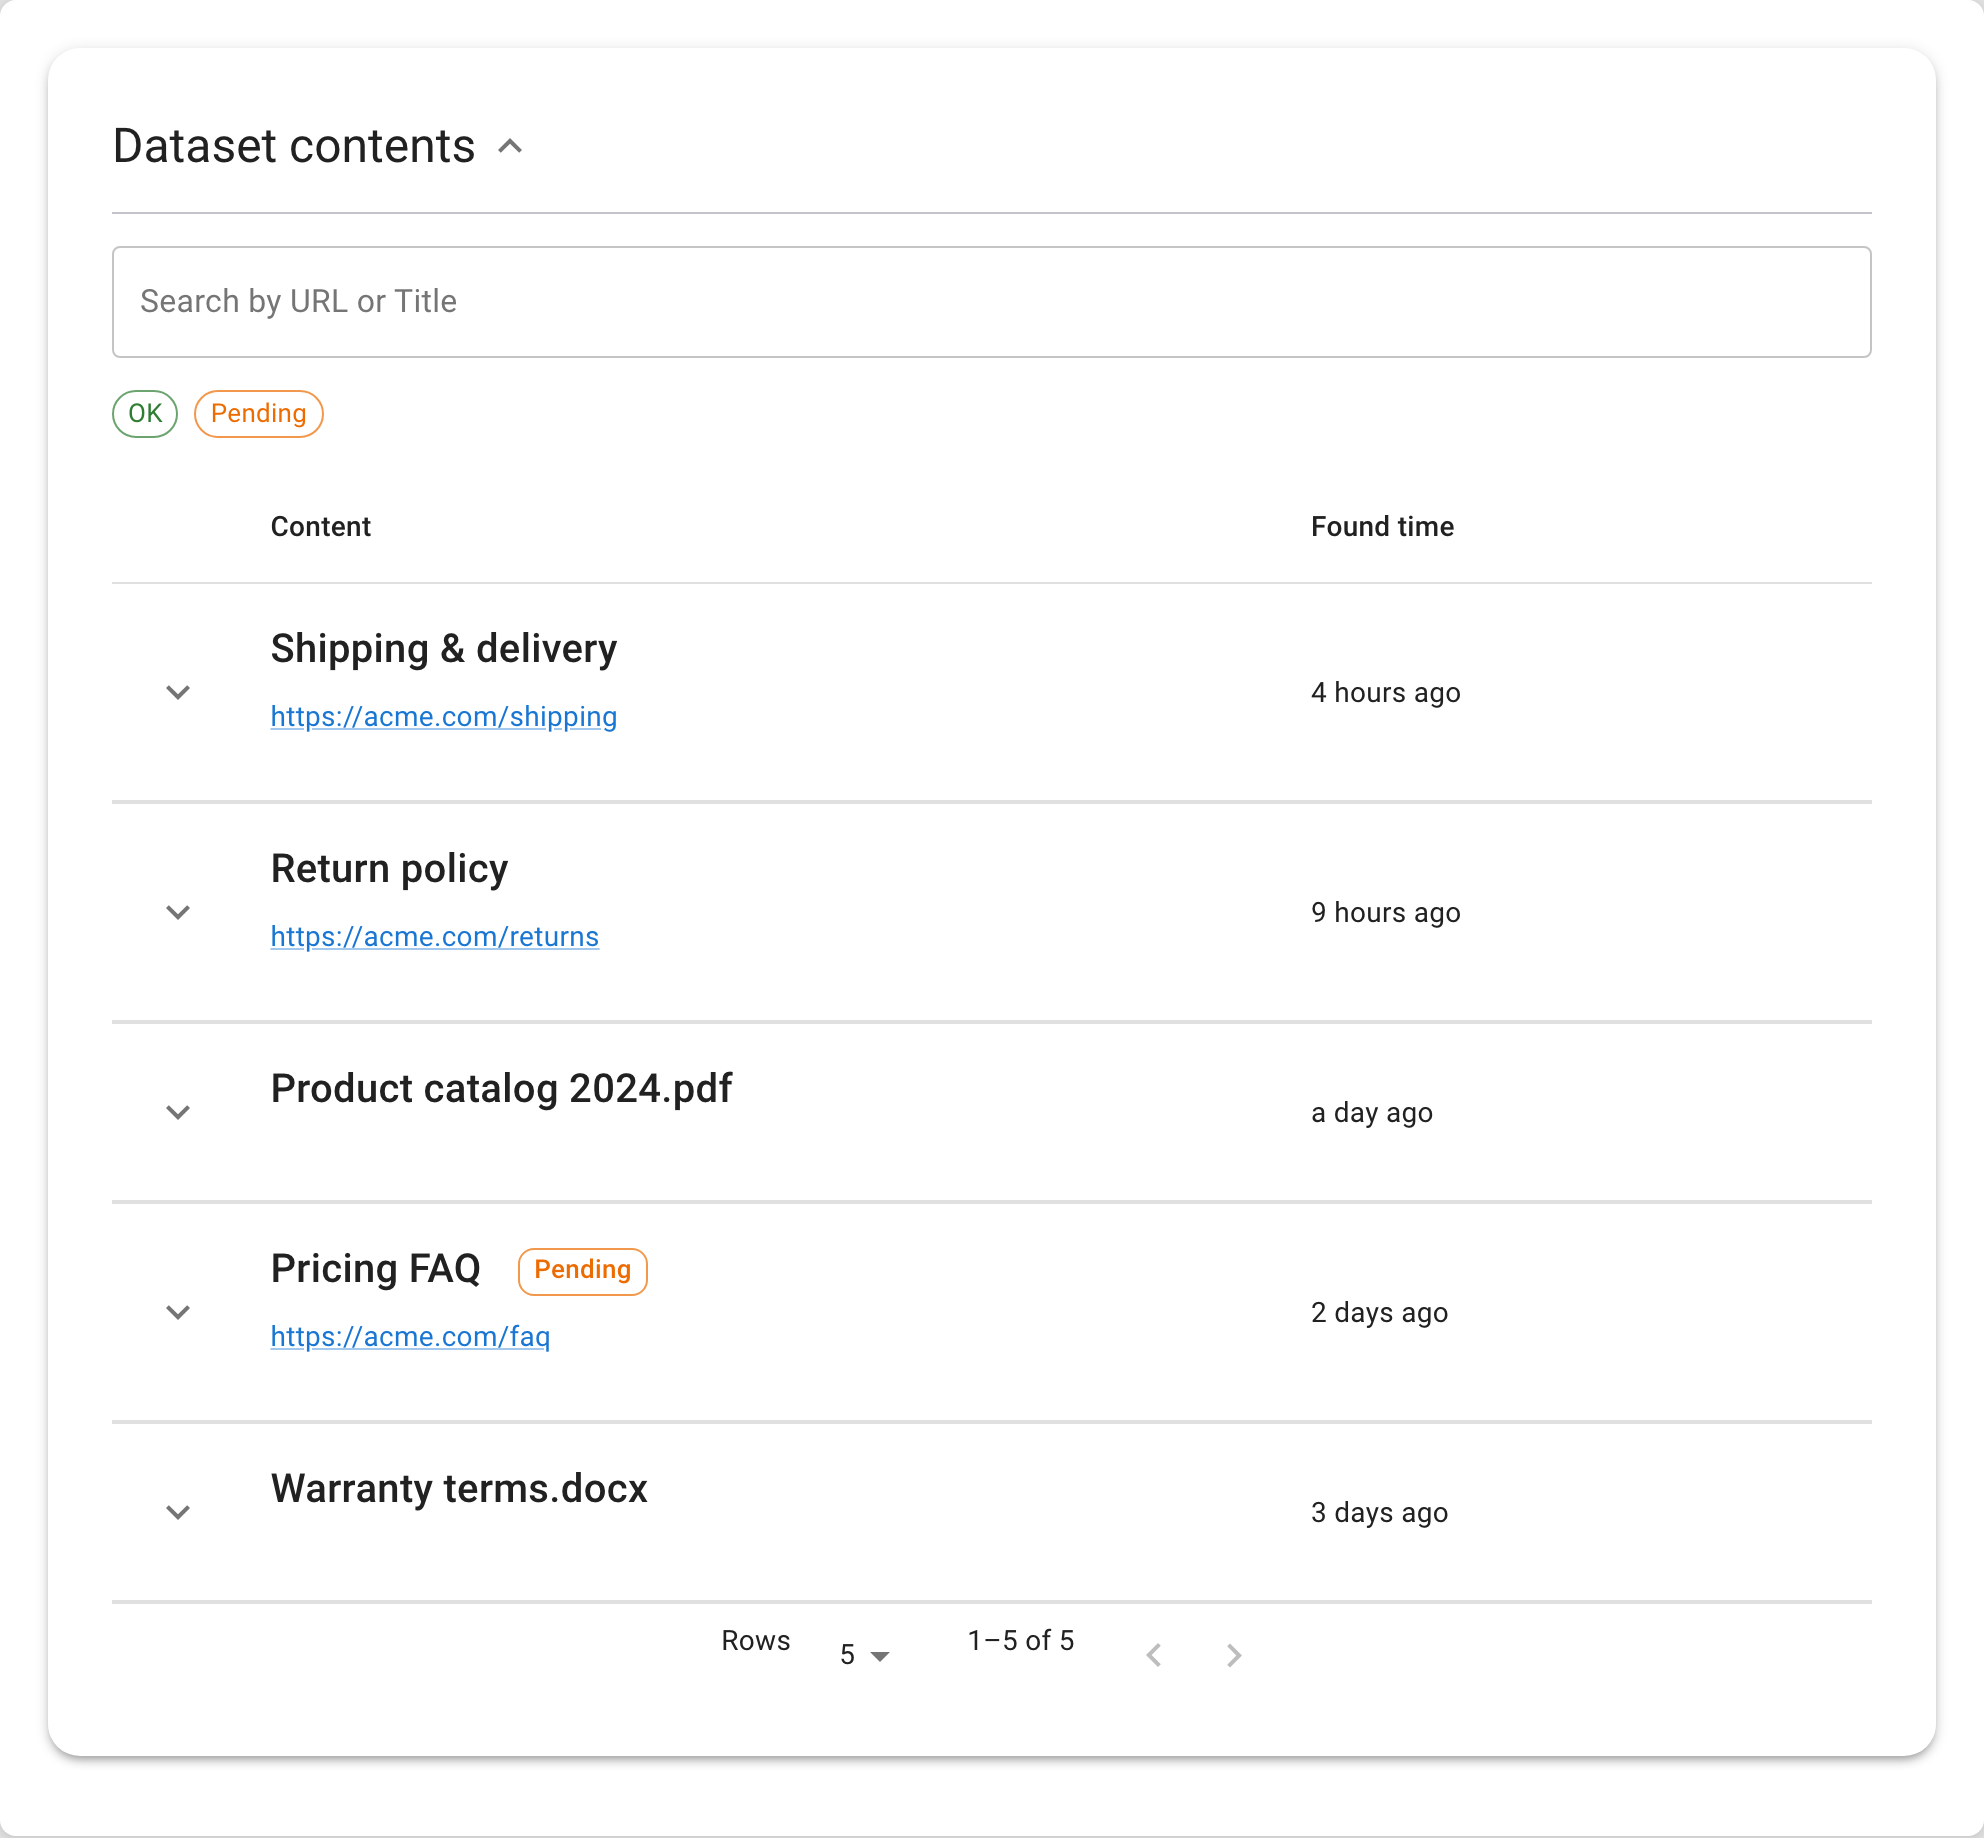
Si el valor importante solo aparece tras iniciar sesión, dentro de una imagen o en un script que la captura no recupera, cambia el método de obtención de la fuente en lugar de rellenar el hueco adivinando.
Valida los resultados estructurados
Prepara una muestra de revisión que incluya páginas habituales, páginas con pocos datos y páginas poco comunes.
| Comprobación | Condición para aprobar |
|---|---|
| Completitud | Los campos obligatorios están presentes o marcados explícitamente como ausentes |
| Exactitud | Los valores coinciden con la fuente visible |
| Coherencia | Los valores equivalentes usan el mismo formato |
| Procedencia | Cada registro conserva su URL de origen |
| Actualidad | La fecha de captura se ajusta a la necesidad del negocio |
| Excepciones | Las páginas con otra plantilla quedan marcadas |
Calcula la exactitud solo a partir de una muestra etiquetada y anota su tamaño. Por ejemplo, "47 de 50 registros revisados coincidían con la fuente" es auditable; "extracción de gran precisión" no lo es.
Exporta sin perder la procedencia
Los datasets de Seekdown se pueden exportar como CSV o JSON. Los datasets Enterprise también se pueden exponer mediante un feed OData para Power Query de Excel o Power BI. Las exportaciones CSV incluyen campos como clave, título, estado, URL, cuerpo, resumen, etiquetas, fuente y fecha de descubrimiento.
Conserva la URL de origen y la fecha de captura en los registros que uses después. Sin ellas, un revisor no puede saber si un valor sorprendente procede de la página, de la regla de extracción o de una captura antigua.