Qu’est-ce qu’un robot d’exploration de site récurrent ?
Un robot d’exploration récurrent revisite un ensemble défini de pages web selon un calendrier. Dans Seekdown, une tâche de capture de données de site web récupère les pages autorisées et traite leur contenu dans un jeu de données mémoire.
La récurrence compte, car un assistant répond à partir du jeu de données, et non directement à partir de la page en ligne au moment où le visiteur pose sa question. Si le jeu de données contient une capture plus ancienne, la réponse peut refléter cet ancien texte.
Récurrent ne veut pas dire sans limites
Un robot d’exploration utile a besoin de limites :
| Réglage | Objectif |
|---|---|
| URL initiales | Définir où commence la découverte |
| Noms d’hôte autorisés | Empêcher la tâche de suivre des liens vers des domaines sans rapport |
| Chemins inclus | Limiter la capture aux sections pertinentes |
| Chemins exclus | Écarter les pages de connexion, archives, paiement ou autres zones indésirables |
| Profondeur de liens | Limiter jusqu’où la découverte suit les liens |
| Plafond de pages | Limiter le nombre de pages récupérées par exécution |
| Planification | Décider quand la tâche s’exécute à nouveau |
Un robot configuré avec la seule page d’accueil peut découvrir bien plus que ce que l’assistant devrait utiliser. Le périmètre fait donc partie de la qualité des réponses et de la gouvernance des données, et ne se résume pas à un réglage du robot.
Ce qu’une exécution récurrente peut faire ou non
Une exécution peut récupérer le texte modifié du site, mettre à jour les enregistrements indexés et rendre le contenu traité disponible pour les assistants connectés.
Elle ne peut pas :
- décider laquelle de deux pages publiques contradictoires fait autorité ;
- récupérer des informations importantes présentes uniquement dans une image illisible ;
- accéder à des contenus privés sans méthode de capture adaptée ;
- garantir que chaque page découverte a été traitée correctement ; ou
- décider si une réponse modifiée est acceptable pour votre équipe.
Ces tâches exigent toujours une responsabilité claire sur les sources et une relecture.
Choisir la récurrence selon le rythme de publication
Commencez par la fréquence la plus lente qui répond au besoin.
- Utilisez une fréquence horaire ou de quelques heures pour les sources qui changent réellement dans la journée.
- Utilisez une fréquence quotidienne pour une documentation active, des actualités ou un catalogue souvent modifié.
- Utilisez une fréquence hebdomadaire pour les manuels et règles stables.
- Utilisez des exécutions manuelles lorsque les changements suivent une publication maîtrisée et ne doivent pas être diffusés avant validation.
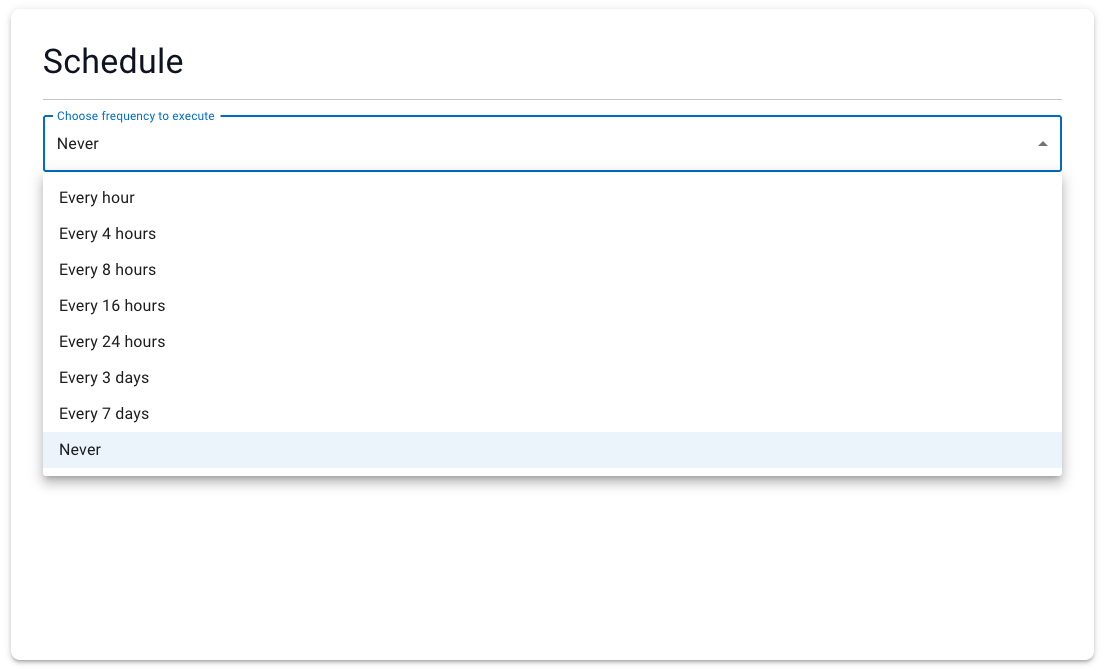
Diviser un site en plusieurs tâches de capture peut être plus clair que d’appliquer à tout le domaine une seule planification agressive.
Quand vous n’en avez pas besoin
Un robot d’exploration récurrent apporte peu lorsque la source est un fichier statique mis à jour une fois par an, que le jeu de données est volontairement figé pour des raisons d’audit, ou que chaque changement doit passer une validation manuelle avant de pouvoir influencer les réponses.
Dans ces cas, un processus documenté d’actualisation manuelle et de vérification peut être plus approprié. L’objectif est un contenu source à jour et maîtrisé, pas la récurrence pour elle-même.