Cos’è un crawler ricorrente per siti web?
Un crawler ricorrente rivisita un insieme definito di pagine web secondo una pianificazione. In Seekdown, un job di acquisizione dati del sito web recupera le pagine consentite ed elabora i loro contenuti in un dataset di memoria.
La ricorrenza conta perché un assistente risponde a partire dal dataset, non direttamente dalla pagina live nel momento in cui il visitatore fa la domanda. Se il dataset contiene un’acquisizione precedente, la risposta può riflettere quel testo più vecchio.
Ricorrente non significa senza limiti
Un crawler utile ha bisogno di confini:
| Controllo | Scopo |
|---|---|
| URL iniziali | Definiscono da dove parte l’individuazione delle pagine |
| Hostname consentiti | Impediscono al job di seguire link verso domini non pertinenti |
| Percorsi inclusi | Limitano l’acquisizione alle sezioni pertinenti |
| Percorsi esclusi | Rimuovono login, archivi, checkout o altre aree indesiderate |
| Profondità dei link | Limita quanto lontano si seguono i link |
| Limite di pagine | Limita quante pagine può recuperare un’esecuzione |
| Pianificazione | Decide quando il job viene eseguito di nuovo |
Un crawler configurato solo con la homepage può individuare molto più di quanto l’assistente dovrebbe usare. Il perimetro fa quindi parte della qualità delle risposte e della governance dei dati, non è solo un’impostazione del crawler.
Cosa può e non può fare un’esecuzione ricorrente
Un’esecuzione può recuperare il testo modificato del sito, aggiornare i record indicizzati e rendere disponibili i contenuti elaborati agli assistenti collegati.
Non può:
- decidere quale di due pagine pubbliche in conflitto sia autorevole;
- recuperare dati importanti presenti solo in un’immagine illeggibile;
- accedere a materiale privato senza un metodo di acquisizione adeguato;
- garantire che ogni pagina individuata sia stata elaborata correttamente; né
- decidere se una risposta modificata sia accettabile per il tuo team.
Queste attività richiedono comunque responsabili delle fonti e revisione.
Scegli la ricorrenza in base al ritmo di pubblicazione
Parti dalla frequenza più lenta che soddisfa le esigenze dei contenuti.
- Usa una frequenza oraria o di qualche ora per le fonti che cambiano davvero durante la giornata.
- Usa una frequenza giornaliera per documentazione attiva, notizie o un catalogo modificato spesso.
- Usa una frequenza settimanale per manuali e policy stabili.
- Usa esecuzioni manuali quando le modifiche seguono un rilascio controllato e non devono essere pubblicate prima dell’approvazione.
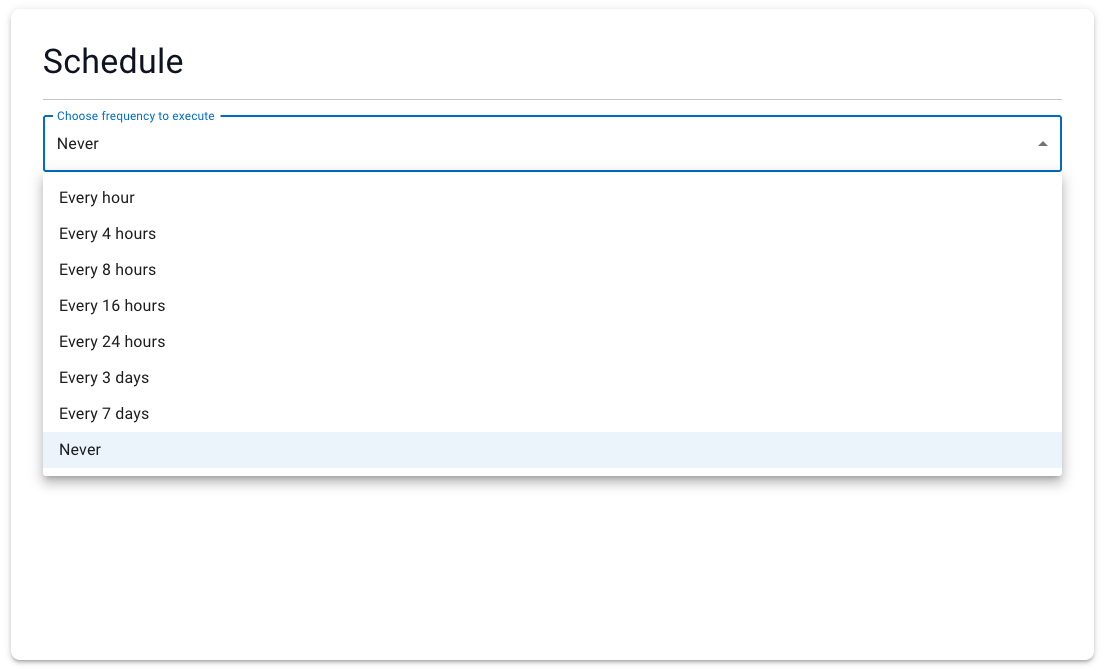
Dividere un sito in più job di acquisizione può essere più chiaro che assegnare all’intero dominio un’unica pianificazione aggressiva.
Quando potresti non averne bisogno
Un crawler ricorrente aggiunge poco valore quando la fonte è un file statico aggiornato una volta all’anno, il dataset è volutamente congelato per motivi di audit o ogni modifica deve superare un’approvazione manuale prima di influenzare le risposte.
In questi casi può essere più adatto un processo documentato di aggiornamento e verifica manuale. L’obiettivo è avere materiale di origine aggiornato e controllato, non la ricorrenza fine a sé stessa.