¿Qué es un rastreador web recurrente?
Un rastreador web recurrente vuelve a visitar un conjunto definido de páginas web de forma programada. En Seekdown, un trabajo de captura de datos web recupera las páginas permitidas y procesa su contenido en un dataset de memoria.
La recurrencia importa porque un asistente responde a partir del dataset, no directamente desde la página publicada en el momento en que pregunta el visitante. Si el dataset contiene una captura antigua, la respuesta puede reflejar ese texto antiguo.
Recurrente no significa sin restricciones
Un rastreador útil necesita límites:
| Control | Finalidad |
|---|---|
| URL iniciales | Definen dónde empieza el descubrimiento |
| Dominios permitidos | Impiden que el trabajo siga enlaces hacia dominios no relacionados |
| Rutas incluidas | Limitan la captura a las secciones relevantes |
| Rutas excluidas | Eliminan zonas de inicio de sesión, archivo histórico, checkout u otras no deseadas |
| Profundidad de enlaces | Limita hasta dónde sigue los enlaces el descubrimiento |
| Límite de páginas | Limita cuántas páginas puede recuperar una ejecución |
| Programación | Decide cuándo vuelve a ejecutarse el trabajo |
Un rastreador configurado solo con una página de inicio puede descubrir mucho más de lo que debería usar el asistente. Por eso el alcance forma parte de la calidad de las respuestas y del gobierno de los datos, no es solo un ajuste del rastreador.
Qué puede hacer y qué no una ejecución recurrente
Una ejecución puede recuperar el texto web modificado, actualizar los registros indexados y poner el contenido procesado a disposición de los asistentes conectados.
No puede:
- decidir cuál de dos páginas públicas contradictorias es la autorizada;
- recuperar datos importantes que solo existen en una imagen ilegible;
- acceder a material privado sin un método de captura adecuado;
- garantizar que todas las páginas descubiertas se hayan procesado correctamente; ni
- decidir si una respuesta modificada es aceptable para tu equipo.
Esas tareas siguen requiriendo responsables de las fuentes y revisión.
Elige la recurrencia según tu forma de publicar
Empieza con la frecuencia más lenta que cubra la necesidad del contenido.
- Usa una frecuencia horaria o de varias horas para fuentes que de verdad cambian durante el día.
- Usa una frecuencia diaria para documentación activa, noticias o un catálogo que se edita a menudo.
- Usa una frecuencia semanal para manuales y políticas estables.
- Usa ejecuciones manuales cuando los cambios siguen una publicación controlada y no deben aplicarse antes de su aprobación.
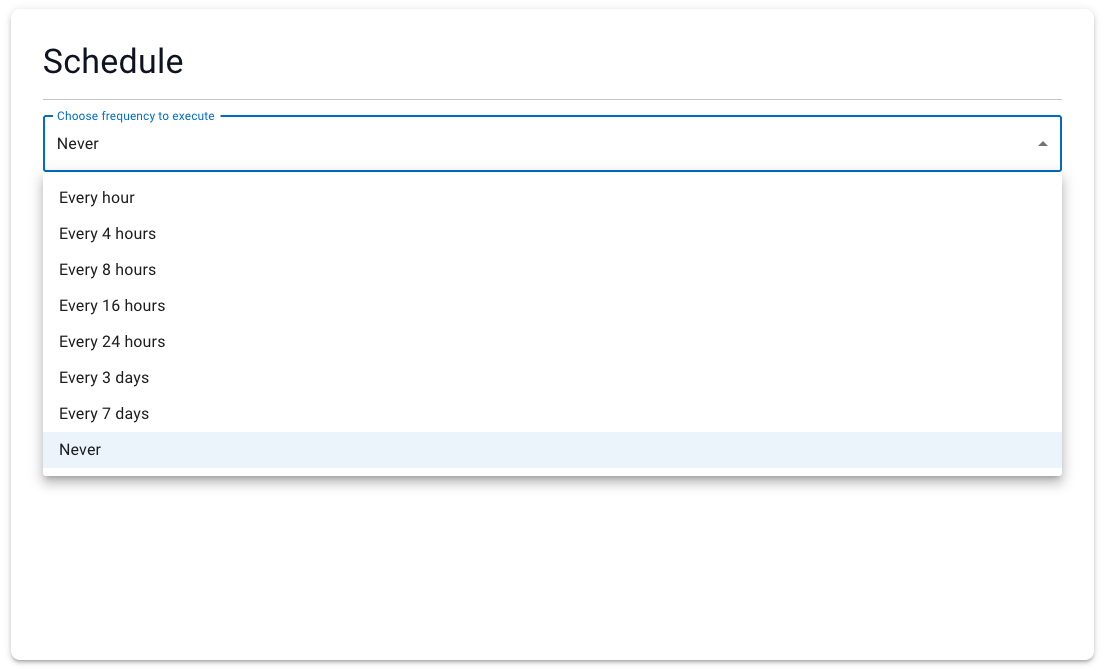
Dividir un sitio en varios trabajos de captura puede ser más claro que dar a todo el dominio una única programación agresiva.
Cuándo puede que no lo necesites
Un rastreador web recurrente aporta poco cuando la fuente es un archivo estático que se actualiza una vez al año, cuando el dataset se congela a propósito por motivos de auditoría o cuando cada cambio debe pasar una aprobación manual antes de afectar a las respuestas.
En esos casos, puede ser más adecuado un proceso documentado de actualización manual y verificación. El objetivo es tener un material de origen actual y controlado, no la recurrencia por sí misma.