Was ist ein wiederkehrender Website-Crawler?
Ein wiederkehrender Website-Crawler besucht eine festgelegte Menge von Webseiten nach Zeitplan erneut. In Seekdown ruft ein Website-Datenerfassungsjob die erlaubten Seiten ab und verarbeitet ihre Inhalte in einen Memory-Datensatz.
Die Wiederholung ist wichtig, weil ein Assistent aus dem Datensatz antwortet – nicht direkt aus der Live-Seite in dem Moment, in dem ein Besucher fragt. Enthält der Datensatz eine ältere Erfassung, spiegelt die Antwort womöglich diesen älteren Text wider.
Wiederkehrend heißt nicht unbegrenzt
Ein nützlicher Crawler braucht Grenzen:
| Steuerung | Zweck |
|---|---|
| Start-URLs | Legen fest, wo die Erkundung beginnt |
| Erlaubte Hostnamen | Verhindern, dass der Job Links auf fachfremde Domains folgt |
| Einbezogene Pfade | Begrenzen die Erfassung auf relevante Bereiche |
| Ausgeschlossene Pfade | Entfernen Login, Archiv, Checkout oder andere unerwünschte Bereiche |
| Linktiefe | Begrenzt, wie weit die Erkundung Links folgt |
| Seitenobergrenze | Begrenzt, wie viele Seiten ein Lauf abrufen kann |
| Zeitplan | Legt fest, wann der Job erneut läuft |
Ein Crawler, der nur mit einer Startseite konfiguriert ist, kann weit mehr finden, als der Assistent nutzen sollte. Der Umfang ist daher Teil der Antwortqualität und der Data Governance – nicht nur eine Crawler-Einstellung.
Was ein wiederkehrender Lauf kann und was nicht
Ein Lauf kann geänderten Website-Text abrufen, indexierte Einträge aktualisieren und die verarbeiteten Inhalte für verbundene Assistenten verfügbar machen.
Er kann nicht:
- entscheiden, welche von zwei widersprüchlichen öffentlichen Seiten maßgeblich ist;
- wichtige Fakten wiederherstellen, die nur in einem nicht lesbaren Bild stehen;
- ohne geeignete Erfassungsmethode auf private Inhalte zugreifen;
- garantieren, dass jede gefundene Seite erfolgreich verarbeitet wurde; oder
- entscheiden, ob eine geänderte Antwort für Ihr Team akzeptabel ist.
Diese Aufgaben erfordern weiterhin Verantwortliche für die Quellen und eine Prüfung.
Die Wiederholung nach dem Veröffentlichungsverhalten wählen
Beginnen Sie mit dem langsamsten Rhythmus, der den inhaltlichen Bedarf erfüllt.
- Nutzen Sie einen stündlichen oder mehrstündlichen Rhythmus für Quellen, die sich tatsächlich im Tagesverlauf ändern.
- Nutzen Sie einen täglichen Rhythmus für aktive Dokumentation, News oder einen häufig bearbeiteten Katalog.
- Nutzen Sie einen wöchentlichen Rhythmus für stabile Handbücher und Richtlinien.
- Nutzen Sie manuelle Läufe, wenn Änderungen einem kontrollierten Release folgen und nicht vor der Freigabe veröffentlicht werden sollen.
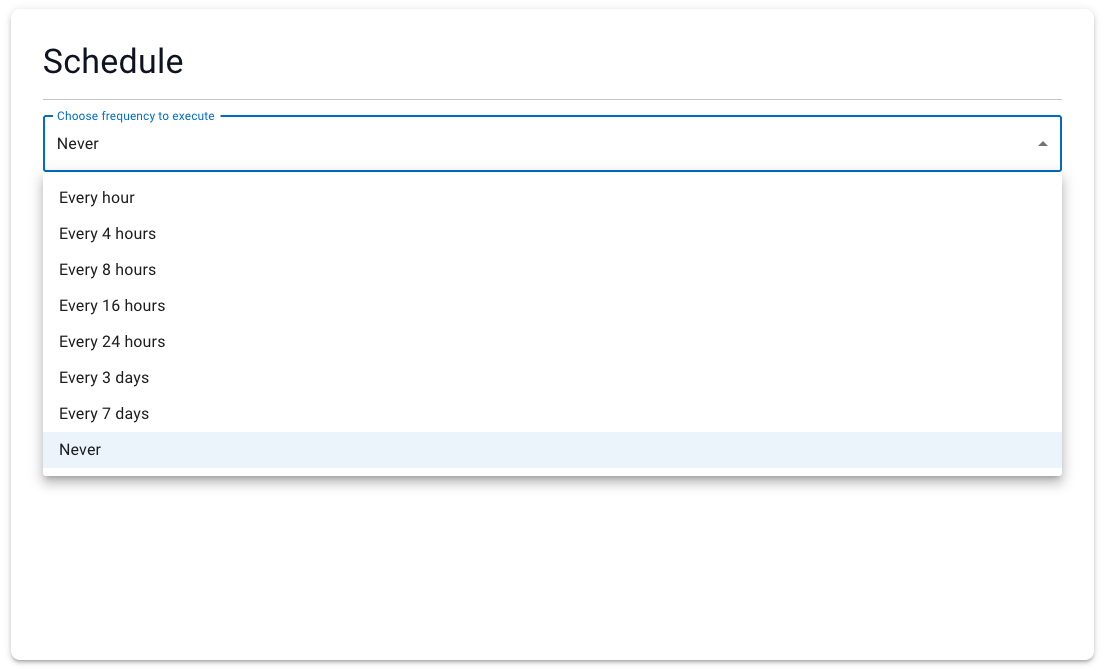
Eine Website auf mehrere Erfassungsjobs aufzuteilen, kann übersichtlicher sein, als der ganzen Domain einen einzigen aggressiven Zeitplan zu geben.
Wann Sie keinen brauchen
Ein wiederkehrender Website-Crawler bringt wenig, wenn die Quelle eine statische Datei ist, die einmal im Jahr aktualisiert wird, wenn der Datensatz aus Audit-Gründen bewusst eingefroren ist oder wenn jede Änderung eine manuelle Freigabe durchlaufen muss, bevor sie Antworten beeinflussen darf.
In diesen Fällen ist ein dokumentierter manueller Aktualisierungs- und Prüfprozess oft angemessener. Ziel sind aktuelle, kontrollierte Quellinhalte – nicht Wiederholung um ihrer selbst willen.