Comment l’exploration d’un site web garde les réponses à jour
Un robot d’exploration de site web ne répond pas aux questions des visiteurs. Il fournit le contenu source à jour dans lequel un assistant peut effectuer ses recherches.
Dans Seekdown, une tâche de capture de données d’un site web passe par les états New, Running, Analysis et Finished. L’état Error peut survenir pendant le processus. Les pages capturées sont traitées et indexées dans le jeu de données mémoire connecté.
Ce qui se passe pendant une exécution
- Découverte : la tâche part des URL configurées et suit les liens autorisés.
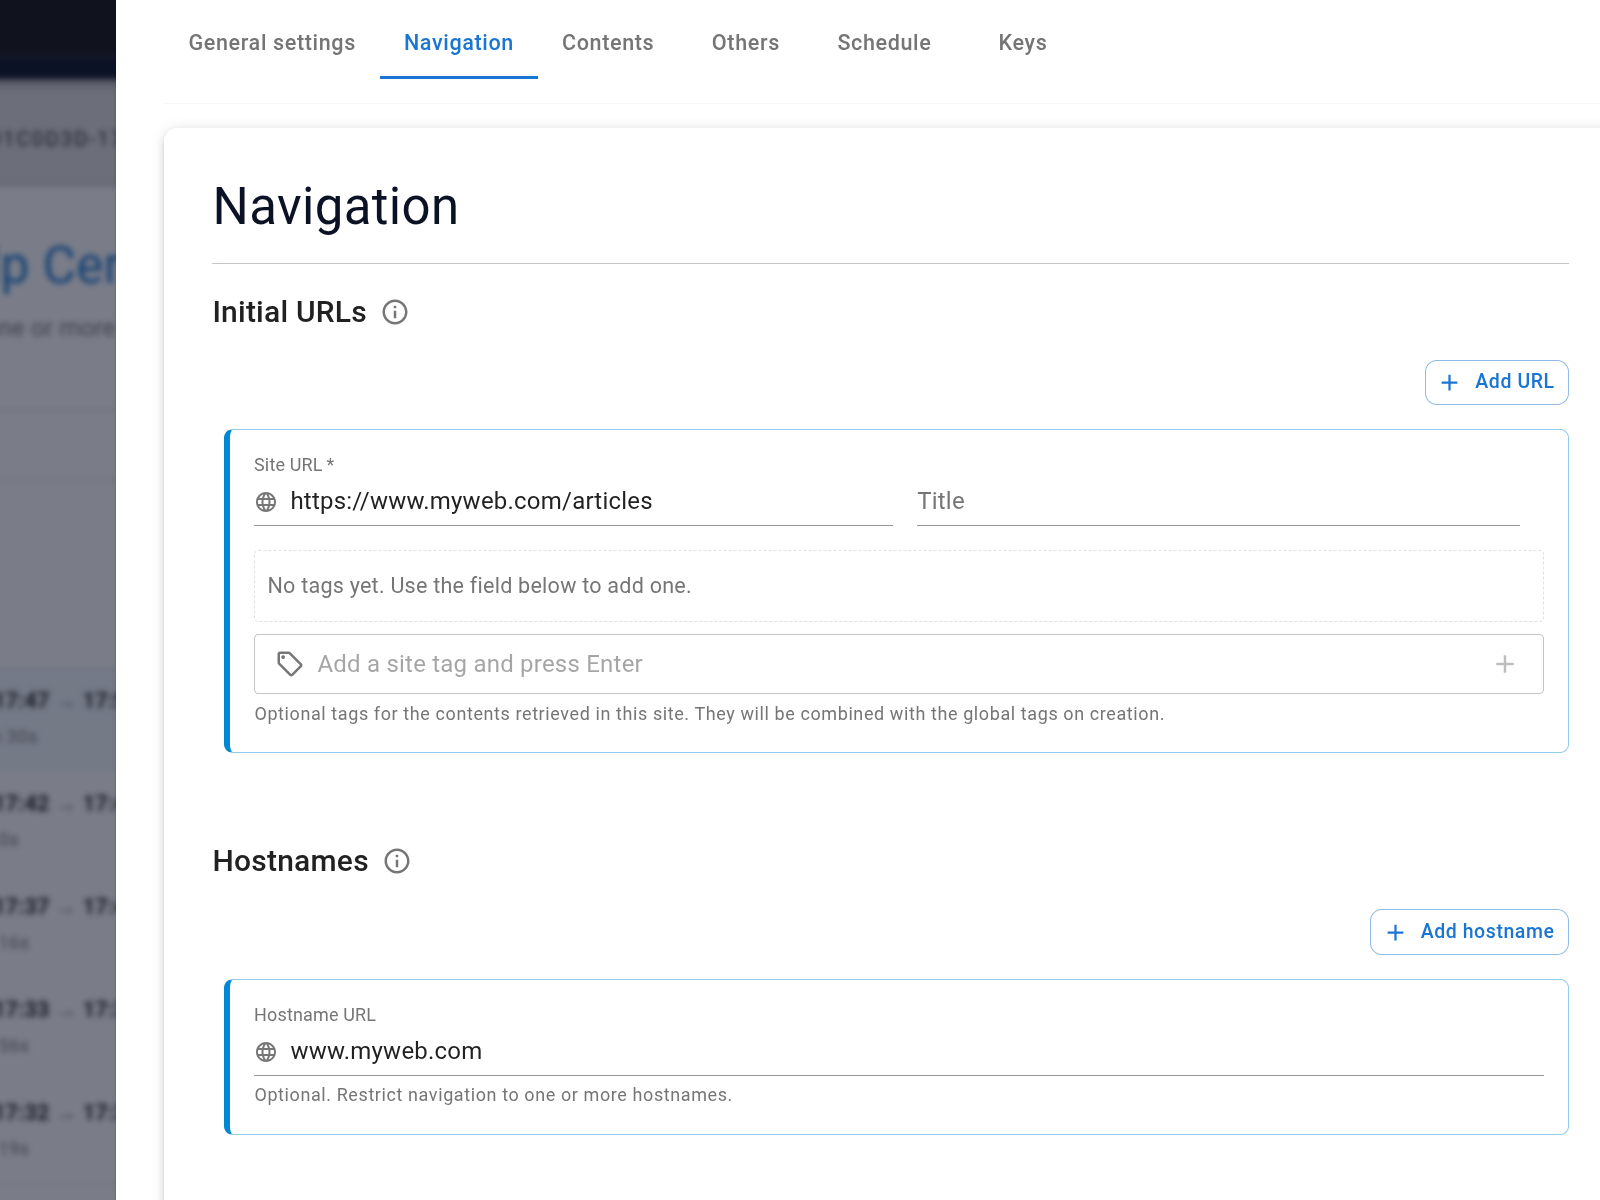
- Récupération : elle ouvre les pages dans les limites de nom d’hôte, de chemin, de profondeur et de nombre de pages.
- Traitement : elle extrait le contenu utile des pages et le prépare pour le jeu de données.
- Indexation : le jeu de données rend le contenu consultable par la recherche.
- Inspection : l’équipe examine les liens découverts, les enregistrements capturés et les erreurs.
Parler de « robot d’exploration IA » peut masquer les réglages opérationnels qui comptent vraiment. La fraîcheur dépend moins de l’étiquette que du fait que les bonnes URL ont été atteintes et traitées.
Les réglages qui influencent la réponse
| Réglage | Risque pour la fraîcheur en cas de mauvaise configuration |
|---|---|
| Noms d’hôte | Un sous-domaine de documentation n’est jamais visité |
| Chemins inclus | Une nouvelle section sort du modèle autorisé |
| Chemins exclus | Une règle trop large supprime une page nécessaire |
| Profondeur des liens | Les pages de détail profondes ne sont jamais découvertes |
| Limite de pages | L’exécution s’arrête avant d’atteindre l’ensemble des sources |
| Planification | Le jeu de données est plus ancien que ne l’exigent les changements des sources |
Après la première exécution, comparez les liens découverts avec un sitemap ou une liste de pages connue. Lors des exécutions suivantes, vérifiez les erreurs récentes et contrôlez ponctuellement les sources modifiées.
Diagnostiquez une réponse obsolète dans l’ordre
- Ouvrez la source en ligne et confirmez qu’elle contient la nouvelle information.
- Confirmez que l’URL fait partie du périmètre de la tâche.
- Vérifiez que la dernière exécution a atteint l’état Finished.
- Retrouvez la page dans les enregistrements capturés.
- Confirmez que le corps dans le jeu de données contient le texte modifié.
- Posez de nouveau la question et ouvrez sa citation.
- Recherchez une autre page indexée qui indique encore l’ancienne information.
Cette séquence permet de distinguer un problème d’exploration d’un conflit entre sources ou d’un problème de réponse.
Une planification peut réduire le travail manuel, mais elle doit s’accompagner d’une question de non-régression pour chaque zone de sources importante. C’est la preuve que le robot d’exploration maintient les réponses alignées sur le site web.