Wie Website-Crawling Antworten aktuell hält
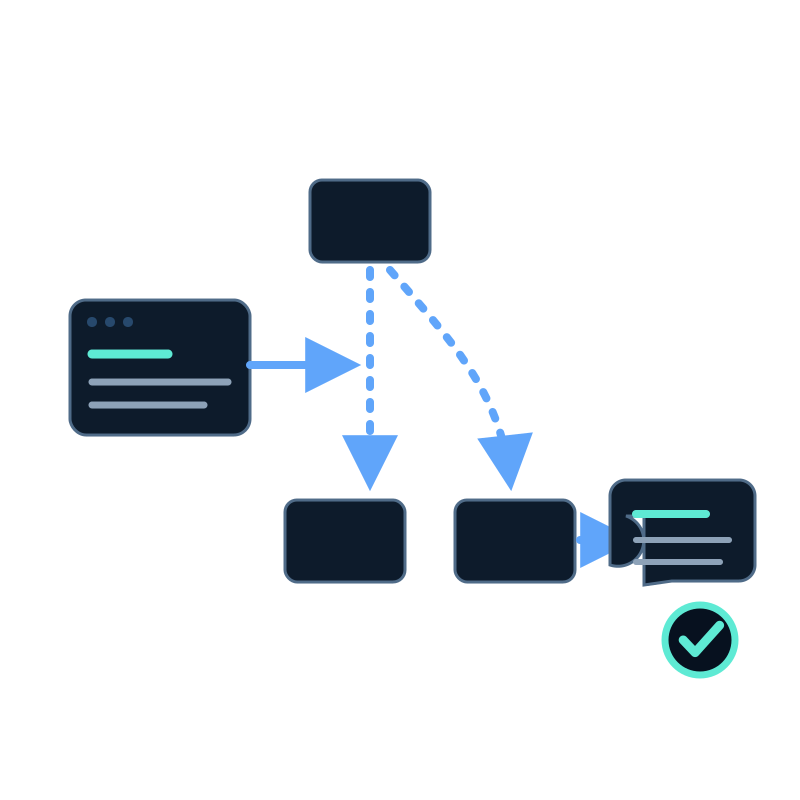
Ein Website-Crawler beantwortet keine Besucherfragen. Er liefert das aktuelle Quellmaterial, in dem ein Assistent suchen kann.
In Seekdown durchläuft ein Website-Datenerfassungsjob die Status New, Running, Analysis und Finished. Während des Ablaufs kann der Status Error auftreten. Die erfassten Seiten werden verarbeitet und im verbundenen Memory-Datensatz indexiert.
Was während eines Laufs passiert
- Entdecken: Der Job startet bei den konfigurierten URLs und folgt erlaubten Links.
- Abrufen: Er öffnet Seiten innerhalb der Grenzen für Hostname, Pfad, Tiefe und Seitenzahl.
- Verarbeiten: Er extrahiert nützliche Seiteninhalte und bereitet sie für den Datensatz auf.
- Indexieren: Der Datensatz macht die Inhalte durchsuchbar.
- Prüfen: Das Team kontrolliert gefundene Links, erfasste Datensätze und Fehler.
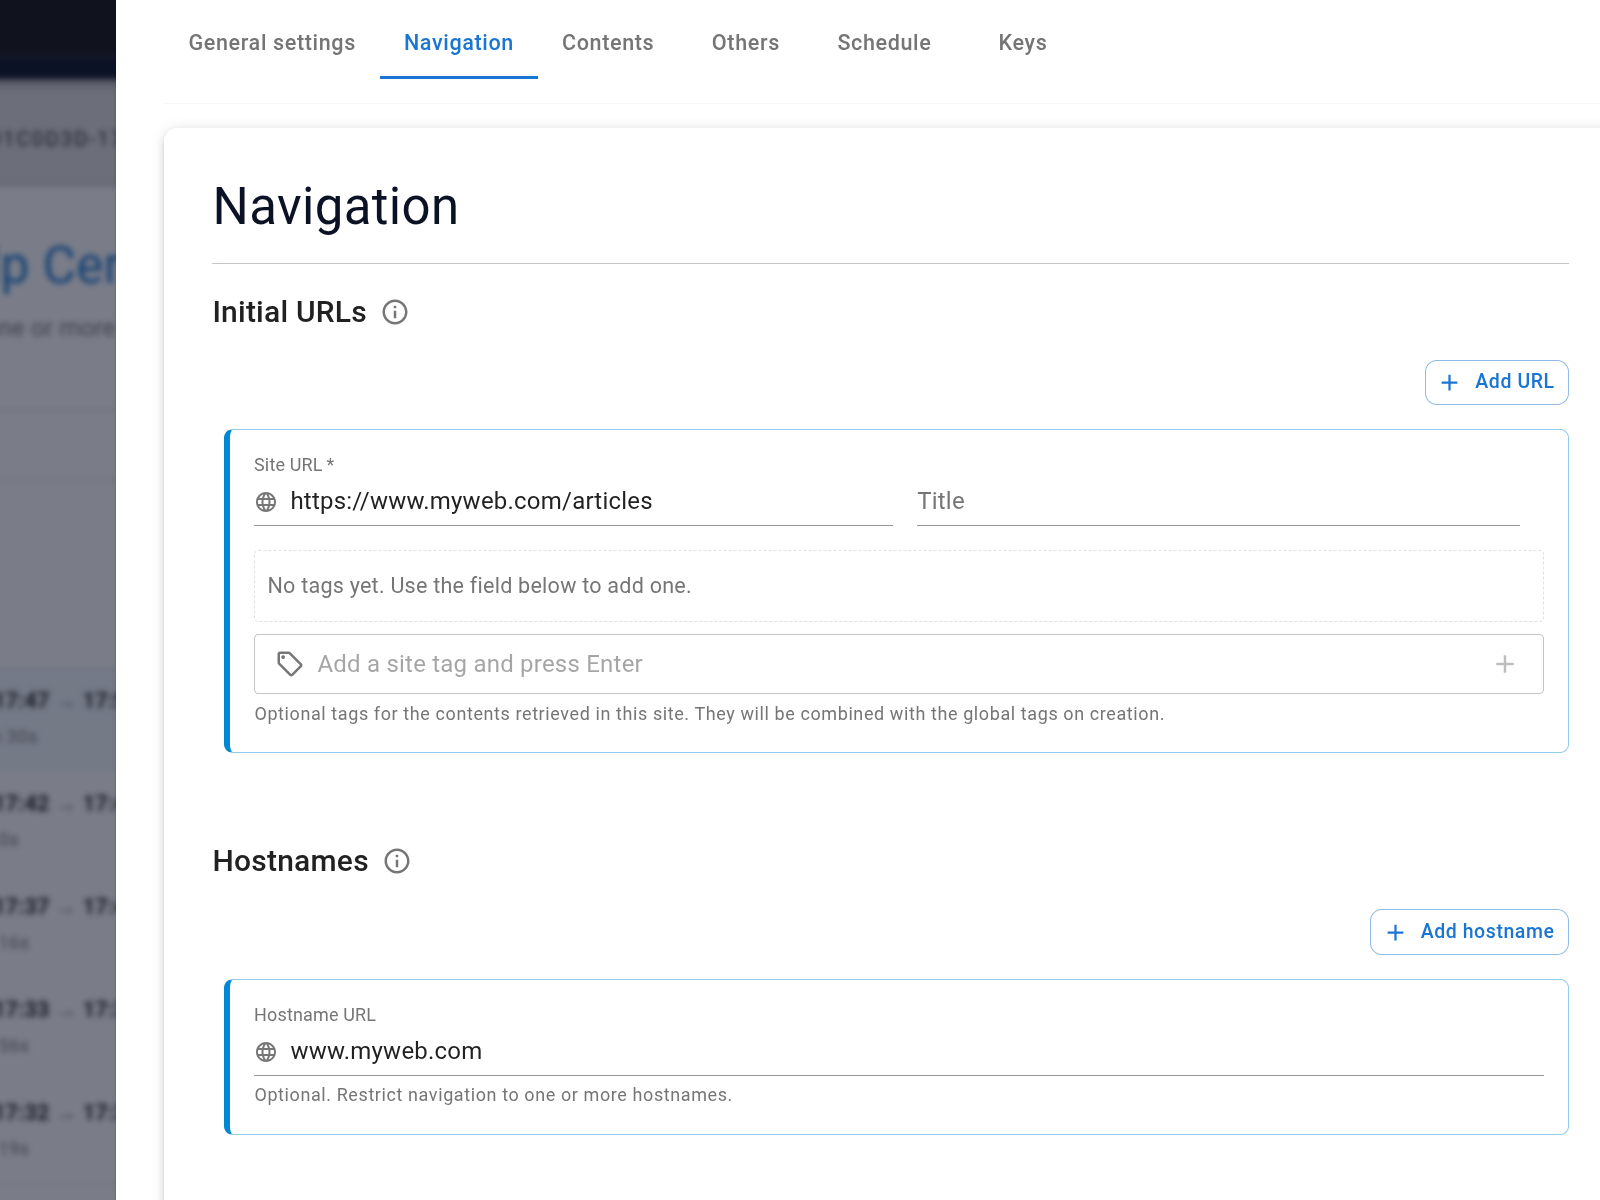
Die Bezeichnung „KI-Website-Crawler“ kann die betrieblichen Einstellungen verdecken, auf die es ankommt. Die Aktualität hängt weniger vom Etikett ab als davon, ob die richtigen URLs erreicht und verarbeitet wurden.
Einstellungen, die die Antwort beeinflussen
| Einstellung | Risiko für die Aktualität bei falscher Konfiguration |
|---|---|
| Hostnamen | Eine Dokumentations-Subdomain wird nie besucht |
| Eingeschlossene Pfade | Ein neuer Bereich fällt aus dem erlaubten Muster |
| Ausgeschlossene Pfade | Eine zu breite Regel entfernt eine benötigte Seite |
| Linktiefe | Tief liegende Detailseiten werden nie gefunden |
| Seitenlimit | Der Lauf endet, bevor alle Quellen erreicht sind |
| Zeitplan | Der Datensatz ist älter, als es die Änderungen an den Quellen erlauben |
Vergleichen Sie nach dem ersten Lauf die gefundenen Links mit einer Sitemap oder einer bekannten Seitenliste. Prüfen Sie bei späteren Läufen die jüngsten Fehler und kontrollieren Sie geänderte Quellen stichprobenartig.
Untersuchen Sie eine veraltete Antwort Schritt für Schritt
- Öffnen Sie die Live-Quelle und bestätigen Sie, dass sie die neue Angabe enthält.
- Bestätigen Sie, dass die URL im Umfang des Jobs liegt.
- Prüfen Sie, ob der letzte Lauf den Status Finished erreicht hat.
- Suchen Sie die Seite in den erfassten Datensätzen.
- Bestätigen Sie, dass der Inhalt im Datensatz den geänderten Text enthält.
- Stellen Sie die Frage erneut und öffnen Sie die Quellenangabe.
- Suchen Sie nach einer anderen indexierten Seite, die noch die alte Angabe enthält.
Diese Reihenfolge unterscheidet ein Crawl-Problem von einem Quellenkonflikt oder einem Antwortproblem.
Ein Zeitplan kann manuelle Arbeit reduzieren, sollte aber mit einer Regressionsfrage für jeden wichtigen Quellbereich kombiniert werden. Das ist der Beleg dafür, dass der Crawler die Antworten im Einklang mit der Website hält.