Come la scansione del sito mantiene aggiornate le risposte
Un crawler non risponde alle domande dei visitatori. Fornisce il materiale sorgente aggiornato in cui l’assistente può cercare.
In Seekdown, un job di acquisizione dati da sito web passa attraverso gli stati New, Running, Analysis e Finished. Durante il flusso può verificarsi lo stato Error. Le pagine acquisite vengono elaborate e indicizzate nel dataset di memoria collegato.
Cosa succede durante un’esecuzione
- Scoperta: il job parte dagli URL configurati e segue i link consentiti.
- Recupero: apre le pagine entro i limiti di hostname, percorso, profondità e numero di pagine.
- Elaborazione: estrae i contenuti utili della pagina e li prepara per il dataset.
- Indicizzazione: il dataset rende i contenuti ricercabili.
- Controllo: il team rivede i link rilevati, i record acquisiti e gli errori.
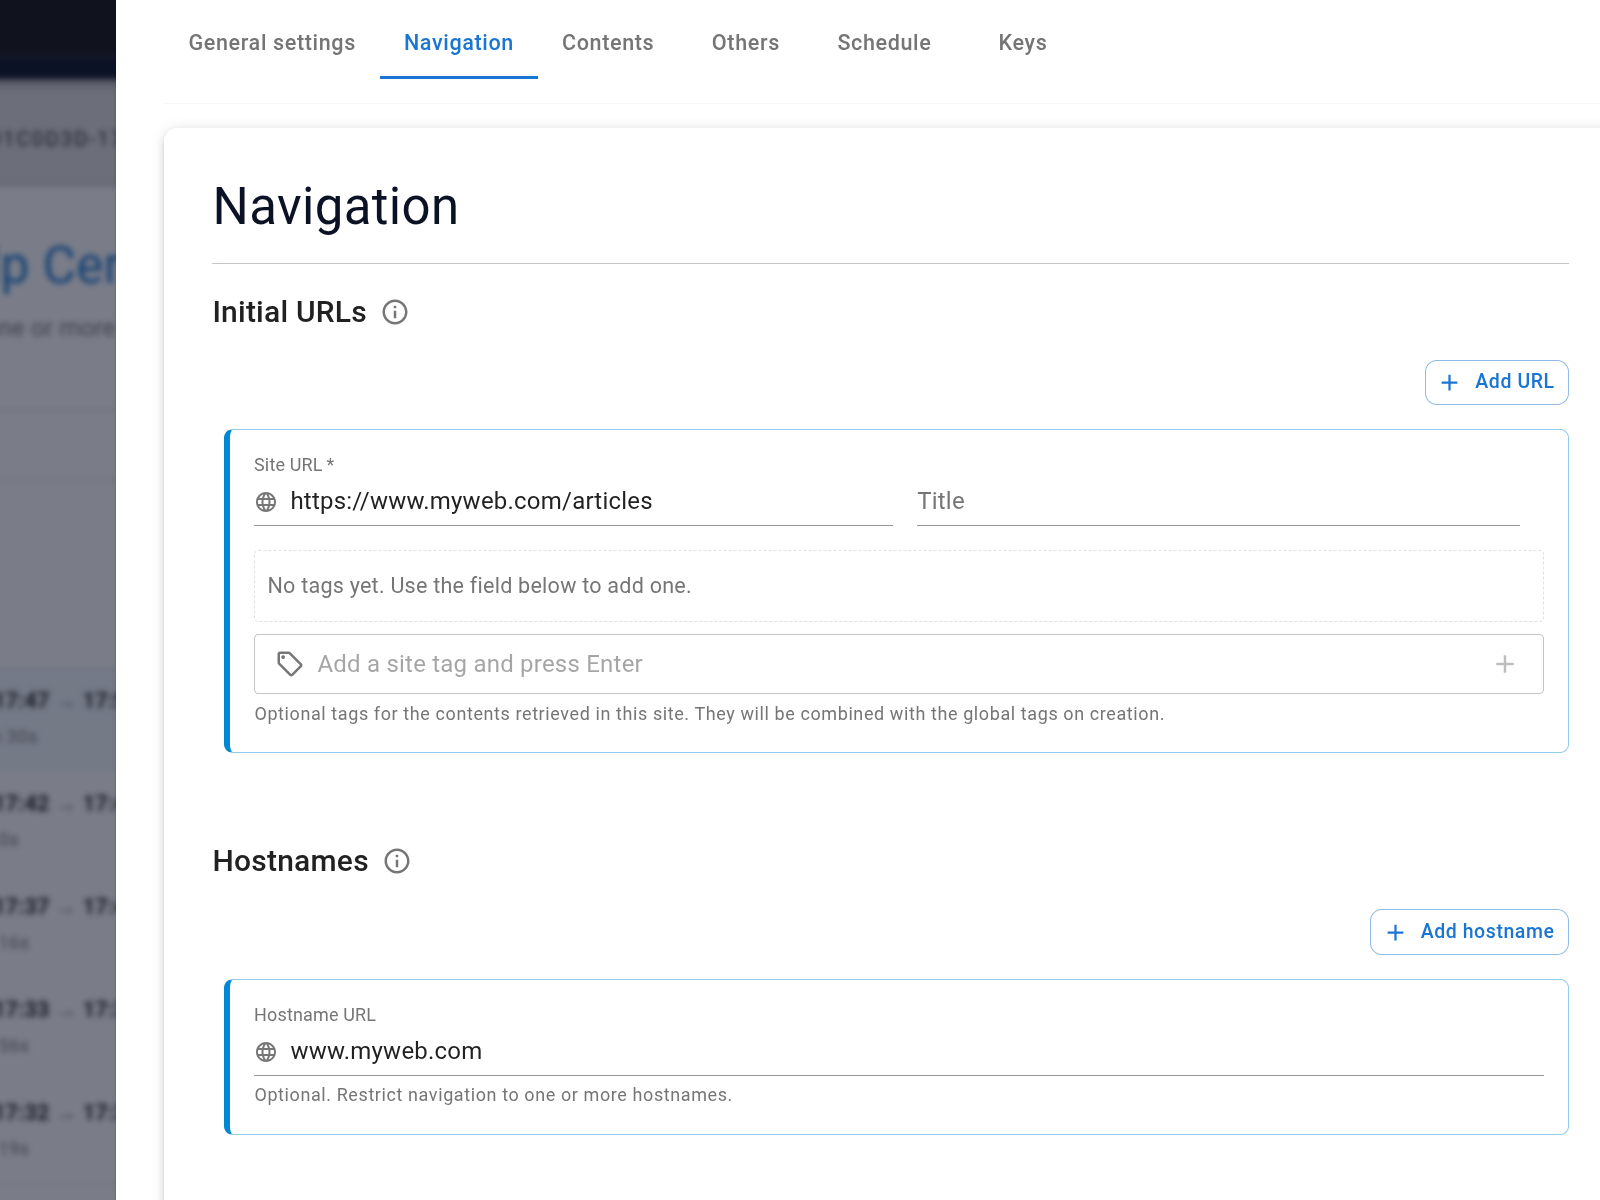
Parlare di "crawler IA" può nascondere i controlli operativi che contano davvero. L’aggiornamento dipende meno dall’etichetta e più dal fatto che gli URL giusti siano stati raggiunti ed elaborati.
I controlli che influiscono sulla risposta
| Controllo | Rischio per l’aggiornamento se configurato male |
|---|---|
| Hostname | Un sottodominio di documentazione non viene mai visitato |
| Percorsi inclusi | Una nuova sezione resta fuori dal pattern consentito |
| Percorsi esclusi | Una regola troppo ampia rimuove una pagina necessaria |
| Profondità dei link | Le pagine di dettaglio più profonde non vengono mai scoperte |
| Limite di pagine | L’esecuzione si interrompe prima di coprire tutte le fonti |
| Pianificazione | Il dataset è più vecchio di quanto richiedano le modifiche alle fonti |
Dopo la prima esecuzione, confronta i link rilevati con una sitemap o con un elenco di pagine noto. Dopo le esecuzioni successive, controlla gli errori recenti e verifica a campione le fonti modificate.
Diagnostica una risposta obsoleta in ordine
- Apri la fonte live e verifica che contenga la nuova informazione.
- Verifica che l’URL rientri nell’ambito del job.
- Controlla che l’ultima esecuzione abbia raggiunto lo stato Finished.
- Trova la pagina tra i record acquisiti.
- Verifica che il corpo nel dataset contenga il testo modificato.
- Ripeti la domanda e apri la sua citazione.
- Cerca un’altra pagina indicizzata che riporti ancora la vecchia informazione.
Questa sequenza distingue un problema di scansione da un conflitto tra fonti o da un problema della risposta.
Una pianificazione può ridurre il lavoro manuale, ma va abbinata a una domanda di regressione per ogni area di fonti importante. È questa la prova che il crawler mantiene le risposte allineate al sito web.