Comment transformer le contenu non structuré d’un site web en données structurées
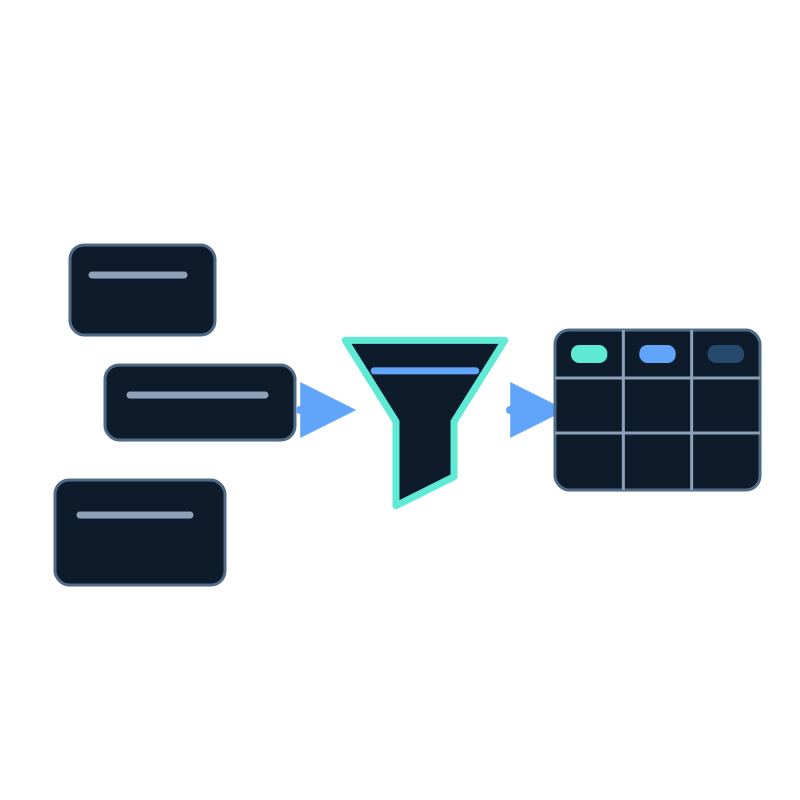
Une page web est conçue pour être lue, pas pour se comporter comme une ligne de base de données. Les titres, le texte, les cartes et les tableaux de caractéristiques peuvent tous décrire la même entité de manières différentes.
Transformer ce contenu en données structurées nécessite deux étapes distinctes : capturer fidèlement la source, puis appliquer un schéma documenté.
Décidez de ce que représente un enregistrement
Un enregistrement peut représenter un produit, une entreprise, une politique, un article, un lieu ou un événement. Mélanger plusieurs entités dans une même ligne produit des champs difficiles à interpréter.
Rédigez un court contrat pour chaque champ :
| Question | Exemple de décision |
|---|---|
| Que signifie le champ ? | publishedDate désigne la date de publication indiquée sur la page |
| Quel est son type ? | Date ISO, texte, nombre, liste ou URL |
| Peut-il être absent ? | Oui ; utiliser une valeur vide plutôt qu’une valeur déduite |
| Peut-il se répéter ? | Les tags et les certifications peuvent être des listes |
| Qu’est-ce qui prouve la valeur ? | L’enregistrement conserve une URL source |
| Comment gérer les conflits ? | Signaler deux valeurs publiées pour vérification |
Capturez des modèles de pages représentatifs
Choisissez des exemples de chaque type de page, pas seulement la page la plus propre. Incluez un enregistrement incomplet, une page avec un tableau, une mise en page plus ancienne et une exception.
Les tâches de capture de données Seekdown récupèrent les pages dans un jeu de données mémoire. La vue du contenu du jeu de données vous permet d’inspecter le titre, l’URL, le corps, le résumé et les autres informations capturées avant de les exporter.
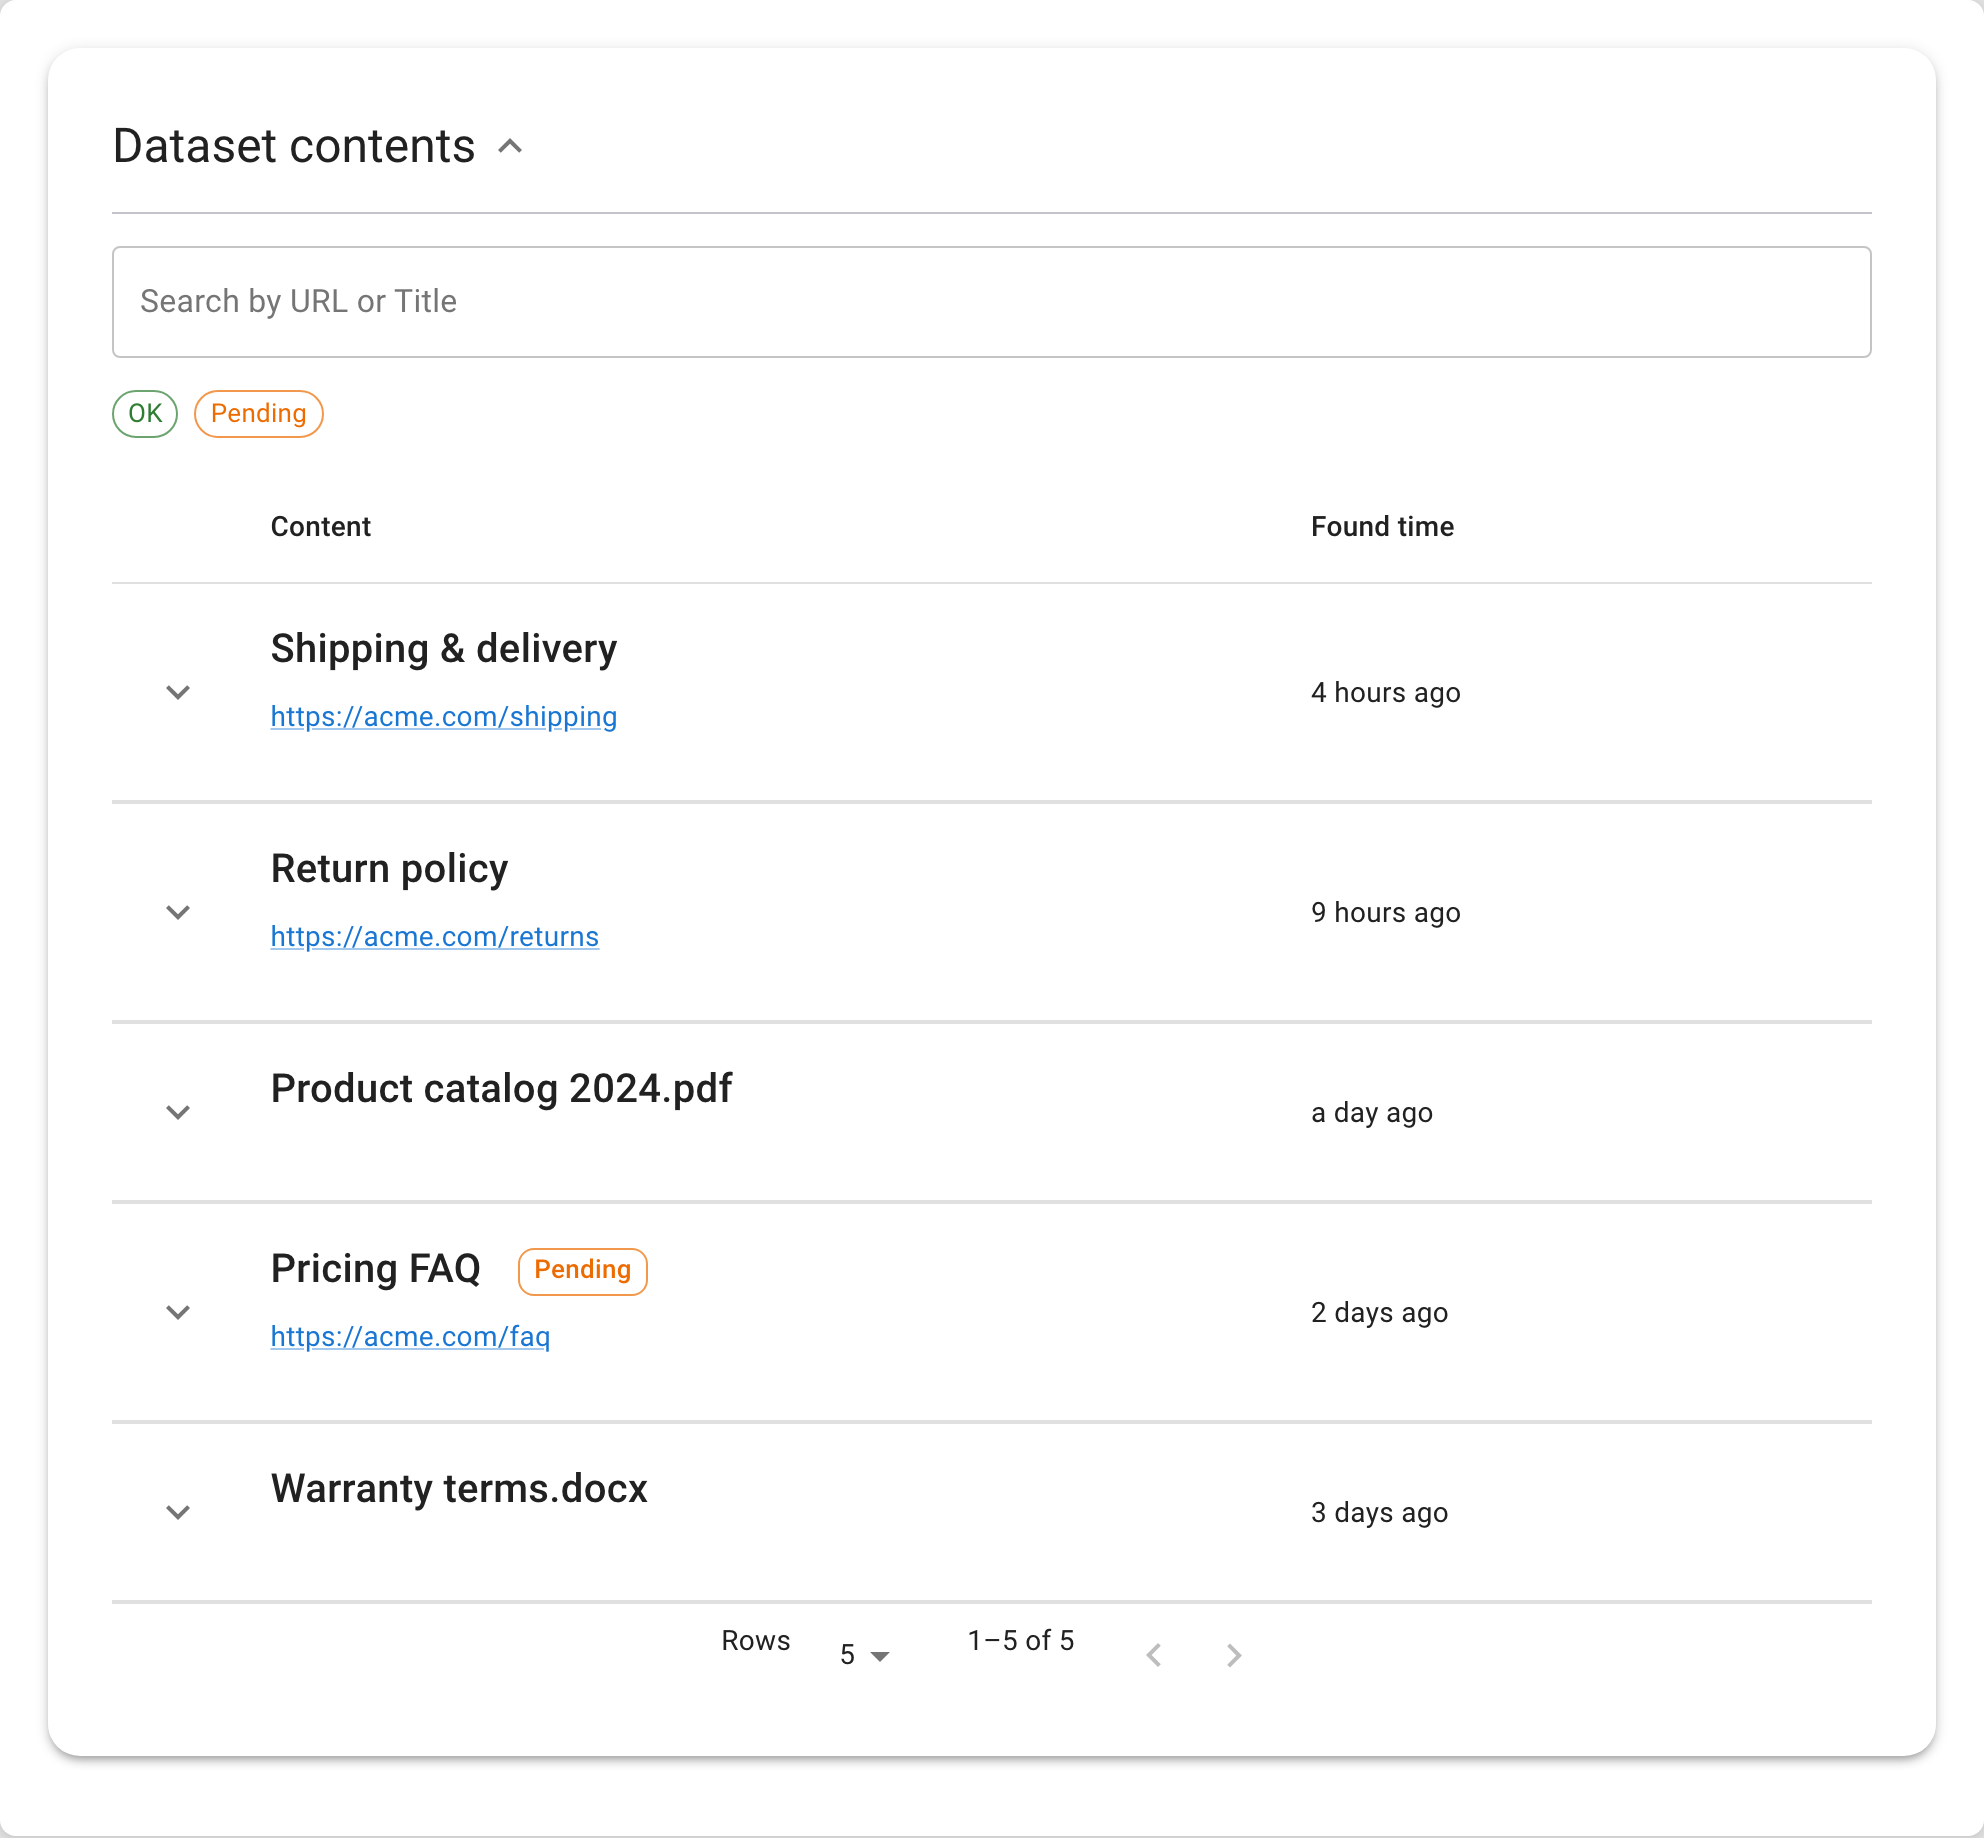
Si une valeur est absente du corps capturé, aucune étape de structuration ultérieure ne pourra la récupérer de manière fiable à partir de cet enregistrement.
Normalisez sans effacer le sens
La normalisation doit rendre comparables les valeurs équivalentes tout en préservant les qualificatifs utiles.
- Convertissez « 16 bar » en valeur 16 et unité bar uniquement si les deux restent disponibles.
- Associez « Oui », « Disponible » et une coche à un même booléen uniquement s’ils ont la même signification.
- Conservez « à partir de », « estimé » et « nous contacter » au lieu de les transformer en prix exacts.
- Gardez le texte d’origine à des fins d’audit lorsqu’une catégorie contrôlée est attribuée.
- Stockez les dates dans un format unique, mais conservez le fuseau horaire publié lorsqu’il compte.
Séparez l’extraction de la validation
Utilisez un échantillon annoté pour mesurer les résultats champ par champ. Consignez séparément les valeurs manquantes, incorrectes et non étayées.
Une page peut produire un enregistrement valide même lorsqu’un champ facultatif est absent. Elle doit échouer lorsqu’une valeur est inventée, rattachée à la mauvaise entité ou privée d’un qualificatif essentiel.
Conservez la provenance dans le jeu de données final
Une valeur structurée sans son URL source ni son heure de capture est difficile à vérifier et risquée à actualiser à l’aveugle.
Choisissez un format adapté à l’usage suivant
Utilisez le CSV pour une vérification dans un tableur, le JSON pour les scripts et les imports, ou un flux OData Enterprise pour une connexion actualisable à Excel ou Power BI. Le format doit répondre au besoin de l’utilisateur final ; il ne change pas la qualité de la source ni du schéma.